Scrapling 是一个 Python 爬虫框架,主张「一个库搞定从单次请求到全站爬取」:HTTP 请求、隐身浏览器、自适应解析、并发 Spider、代理轮换、断点续爬、MCP 服务端,全塞在一个 pip 包里。
项目:https://github.com/D4Vinci/Scrapling(95,868 Star · 10,051 Fork · BSD-3-Clause · Python)
它 2024 年 10 月建库,两年做到近 10 万 star,月下载量约 92 万次。这个量级已经不是「小众工具」,而是一个正在收敛的生态位。
本文数字均为 2026-11-04 通过 GitHub REST API 与 PyPI JSON API 实测,非引用二手报道。
01 · 硬数据
| 维度 | 实测值 | 备注 |
|---|---|---|
| Star / Fork | 95,868 / 10,051 | 关注度极高 |
| Watchers | 339 | 相对 star 偏低,围观多于参与 |
| 建库 / 最近 push | 2024-10-13 / 2026-11-04 | 存续 2 年 |
| Commit 总数 | 1,786 | 平均每天 2.4 次 |
| 贡献者 | 42 | 第一人占 94.3% |
| Release / PyPI 版本 | 54 / 54 | 首个 0.1(2024-10-13),最新 0.5(2026-10-17) |
| Issue / PR | 180 / 305 | 当前仅 10 个 open issue |
| 月下载量(PyPI) | 919,855 | 近 7 天 298,235 |
| 许可证 | BSD-3-Clause | 商用友好 |
贡献者分布(/contributors?anon=1):
D4Vinci        1684   ← 94.3%
yetval           17
AbdullahY36      10
SulimanAbdulrazzaq 10
Yigtwxx           8
mhillebrand       4
haosenwang1018    4
Bortlesboat       4
mturac            3
(其余 33 人 ≤2 次)
42 个贡献者,94% 的代码来自一个人。 作者是 Karim Shoair(D4Vinci),安全研究方向出身——这个背景能解释为什么库里有 Cloudflare 破解和指纹伪装。
代码构成(git/trees/main?recursive=1,692 个文件,未截断):
| 类别 | 文件数 | 体积 | 说明 |
|---|---|---|---|
源码(scrapling/) | 61 | 630 KB | 库本体 |
测试(tests/) | 99 | 1,054 KB | 是源码的 1.67 倍 |
文档(docs/**/*.md) | 389 | 5.72 MB | 含 9 种语言 360 个译文文件 |
| CI 工作流 | 4 | — | tests / code-quality / release / docker |
测试代码比源码还多——这在爬虫库里是罕见比例,因为爬虫库最难写测试(要对抗会变的真实网站)。
02 · 它到底是什么
一句话:它把原本需要拼 4~6 个库才能做的事,收进了一个 import。
传统 Python 爬虫的组合拳是这样的:
| 需求 | 传统方案 |
|---|---|
| 快速 HTTP + 绕过 TLS 指纹检测 | curl_cffi |
| 解析 HTML | BeautifulSoup + lxml,或 parsel |
| JS 渲染 / 过 Cloudflare | Playwright + undetected 补丁 |
| 并发爬取 / 断点续爬 / 限速 | Scrapy |
| 代理轮换 | 自己写 |
| 给 AI 用 | 自己包一层 MCP |
Scrapling 的答案是:这些全都有,且用同一套 Response / Selector 对象贯通。
from scrapling.fetchers import Fetcher

page = Fetcher.get('https://quotes.toscrape.com/')
quotes = page.css('.quote .text::text').getall()
Response 对象继承 Selector,所以拿到页面之后,CSS、XPath、find_all、find_by_text、正则搜索全都能直接用,不用在 fetcher 和 parser 之间倒手。
底层依赖(pyproject.toml 的 [project] dependencies):
lxml>=6.1.1          cssselect>=1.5.0     orjson>=3.11.8
tld>=0.13.2          w3lib>=2.4.1         typing_extensions
fetchers 可选组才会拉进 curl_cffi、playwright、patchright、browserforge、apify-fingerprint-datapoints。
这个分层设计值得注意:pip install scrapling 只装解析引擎(6 个依赖),不装任何浏览器。想用 fetcher 必须 pip install "scrapling[fetchers]" + scrapling install 下载 Chromium。作者把「轻」和「重」切得很干净——但也意味着第一次用会踩 ModuleNotFoundError,README 里专门用 IMPORTANT 提示框警告这一点。
03 · Fetcher 还是 StealthyFetcher
Fetcher | StealthyFetcher | |
|---|---|---|
| 相对速度 | 🐇🐇🐇🐇🐇 | 🐇🐇🐇 |
| 隐身能力 | ⭐⭐ | ⭐⭐⭐⭐⭐ |
| JS 渲染 | ❌ | ✅ |
| 内存占用 | ⭐ | ⭐⭐⭐ |
| 底层 | curl_cffi | Playwright(Chromium / Chrome) |
| 适用 | HTTP 请求能拿到完整内容时 | 动态加载、反爬复杂的中小站点 |
选择逻辑很干脆:
三条使用路径的差别在于代价:Fetcher 是纯 HTTP,秒级;StealthyFetcher 要起浏览器,内存和耗时高一个量级;solve_cloudflare=True 还要额外等挑战通过。
一个细节值得记:Fetcher 支持 impersonate='chrome'——伪装成浏览器真实的 TLS 指纹,而不只是改 User-Agent。这两者在反爬面前差别巨大:UA 随便改,但 JA3 指纹对不上就露馅。
with FetcherSession(impersonate='chrome') as session:
    page = session.get('https://quotes.toscrape.com/', stealthy_headers=True)
04 · adaptive parsing:让选择器活过网站改版
这是 Scrapling 最有辨识度的功能,也是我认为它唯一「别人抄不走」的部分。
老问题:page.css('#p1') 在网站改版后必然失效,然后你半夜收到报警。
Scrapling 的做法是:第一次选中元素时把它的特征存进 SQLite,改版后用相似度重新找回来。
存的特征(docs/parsing/adaptive.md 原文):
元素的标签名、文本、属性(名与值)、兄弟节点(仅标签名)、路径(仅标签名);父节点的标签名、属性、文本。
匹配时逐项打分,取相似度最高的元素返回。不经过 AI,不调用模型,纯相似度算法。
文档里给了个真实可复现的例子:用 2010 年 Stack Overflow 的存档页(Wayback Machine)保存特征,再用同一个选择器去抓 2026 年的现站,两边返回同一个「Questions」按钮。
这套设计的关键洞察是:元素的一切属性都可能被网站改掉,所以不能拿任何单一属性当唯一 ID。 作者的解法是把域名 + 自定义 identifier 作为数据库主键,特征只用于打分——这比「缓存选择器」或「靠 AI 重新生成选择器」都稳,因为前者失效时你连回退都没有,后者每次要花 token 且结果不可复现。
代价也清楚:相似度匹配是启发式,会误匹配。特征存多了库会膨胀;adaptive_domain 这类参数说明跨域名场景需要手动干预。
05 · Spider:并发、断点续爬、现成模板
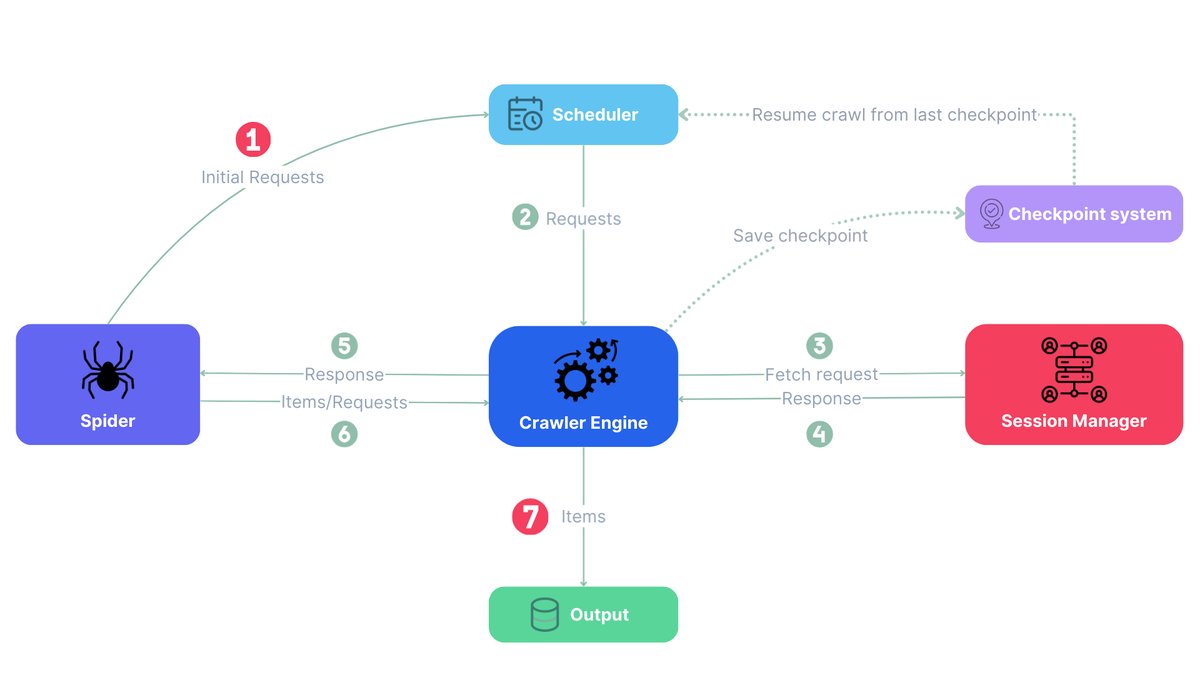
官方给的架构图很干净:Spider 定义抓取规则 → Crawler Engine 调度 → Session Manager 分发到不同 fetcher → Items 输出;中途 Checkpoint system 落盘,重启后从断点续爬。
代码形态接近 Scrapy,但用 async:
class QuotesSpider(Spider):
    name = "quotes"
    start_urls = ["https://quotes.toscrape.com/"]
    concurrent_requests = 10

    async def parse(self, response: Response):
        for quote in response.css('.quote'):
            yield {"text": quote.css('.text::text').get(),
                   "author": quote.css('.author::text').get()}
几个在爬虫实战里真正省事的能力:
| 能力 | 解决的问题 |
|---|---|
crawldir="./crawl_data" + Ctrl+C | 断点续爬。保存 pending 请求与已见 URL,重启从同一目录恢复 |
| 多 Session 混用 | 同一个 Spider 里,普通页走 HTTP、受保护页走隐身浏览器,用 sid 路由 |
AutoThrottle | 不用猜 delay。按目标站点响应速度自动调,被限流时翻倍或按 Retry-After 等 |
| Development Mode | 首次跑把响应缓存到磁盘,之后重放——改 parse() 逻辑不用反复打目标站 |
ShopifySpider | 直接拉整站商品目录,每个 SKU 一条 |
result.items.to_json() | 内置 JSON / JSONL / CSV / XML 导出 |
Development Mode 是这里最实用的一条。 爬虫开发 90% 的时间花在调解析逻辑,而每次调试都要重新请求目标站——既慢又容易被封。缓存重放把这件事从「每次都联网」变成「一次联网 + N 次本地」,本质上是给爬虫加了单元测试的能力。
robots.txt 遵守是可选项(robots_txt_obey),默认不开启。这一点后面会提。
06 · 对 AI 的三层接口
2026 年的开源库如果还只提供 Python API,基本等于自绝于 AI 生态。Scrapling 给了三层,且分层很清楚:
| 层 | 形态 | 给谁用 |
|---|---|---|
| MCP 服务端 | 16 个工具(browser_fetch、browser_actions、browser_screenshot、browser_network_requests…) | Claude / Cursor 等任意 MCP 客户端 |
| Agent Skill | 一个 ZIP,含完整 API 指南与示例 | 编码 agent(Claude Code / OpenClaw) |
page.markdown() | 一行把任意页面转成干净 Markdown | RAG 管道 |
MCP 那层的设计思路值得看:它不是「把 Python 函数暴露出去」,而是把浏览器操作拆成 agent 能组合的原子动作。
browser_actions:一次调用里串起填表、点击、悬停、滚动、按键、处理弹窗、等待——遇到第一个错误就停。这样 agent 不用每一步都往返一次模型。browser_extract:不重新加载页面,直接读当前页或单个元素,支持 HTML / Markdown / text / 带元素角色和坐标的快照。browser_network_requests:读页面背后的 API 调用。默认隐藏静态资源,历史有容量上限。browser_save_state/load_state:登录状态存成 Playwright 兼容 JSON,下次复用。
文档里明确写了对抗 prompt 注入的意图:
它用了大量方法来减少发送给模型的内容、拦截广告,并保护其免受 Prompt 注入。
这一点很关键——把网页内容喂给 AI,本质是把不可信输入喂进模型。 一个爬虫 MCP 服务端如果不做这层防护,等于给目标站点开了一个直通 agent 的注入通道。
page.markdown() 那层则是纯本地转换,不调模型:
md = page.markdown() # 干净、去噪、LLM-ready
配合 ContentSpider 模板,可以把整站爬成一份 Markdown 语料——构建 RAG 知识库时不需要任何 LLM 参与。
07 · 性能数字:哪部分可信,哪部分别信
README 给了一张 5000 层嵌套元素的文本提取基准(benchmarks.py,100+ 次取平均):
| # | 库 | 耗时 (ms) | vs Scrapling |
|---|---|---|---|
| 1 | Scrapling | 1.99 | 1.0x |
| 2 | Parsel / Scrapy | 2.06 | 1.035 |
| 3 | Raw Lxml | 2.56 | 1.286 |
| 4 | PyQuery | 23.98 | ~12x |
| 5 | Selectolax | 197.02 | ~99x |
| 6 | MechanicalSoup | 1545.15 | ~776x |
| 7 | BS4 + Lxml | 1562.10 | ~785x |
| 8 | BS4 + html5lib | 3412.73 | ~1715x |
前四行可信,第五行要打问号。
Scrapling、Parsel、Raw Lxml 三者都在 2ms 量级,因为它们底层是同一个 lxml(benchmarks.py 里注释也写了「Scrapling 和 Parsel 内部用同一个 parser,这样才公平」)。这个排序符合工程直觉。
但 Selectolax 197ms 明显异常——selectolax 基于 Modest/lexbor,通常是最快的 HTML 解析器之一,不该比 raw lxml 慢 77 倍。合理推测是基准只测了 cssselect 路径,而 selectolax 的 .css() 走自己的 CSS 引擎、再逐个调 .text(),在 5000 层深嵌套下退化。这是基准设计的问题,不是库的问题。
BS4 那两行倒是可信:BeautifulSoup 慢是公开事实,html5lib 比 lxml 慢一倍也是常识。
我的建议:把这张表当「Scrapling 不比 Parsel / lxml 慢」的证据看,别当「Scrapling 最快」的证据看。 前者的结论成立,后者需要独立复测。
另一个数字:README 声称 92% 测试覆盖率、完整类型标注、已被数百名爬虫日常使用一年。前两项可以从 tox.ini 的 --cov=scrapling --cov-report=xml 和 CI 里的 mypy / pyright / vermin 看出配置是真的;具体百分比我没有复测。第三项无法验证。
08 · README 的另一半:赞助商
这件事值得单独说,因为它解释了整个赛道的商业模式。
README.md 共 38,299 字节 / 629 行,「Key Features」这一章从第 267 行才开始——前面 18,419 字节(48%)是赞助商和广告位。
列出来的厂商清一色是代理 IP 服务商:NodeMaven、Hyper Solutions、Evomi、TikHub、SwiftProxy、Byteful、ProxyLane、LundProxy、Resolvr、NoneCap、DataImpulse、Decodo、ProxyEmpire、Webshare、Proxiware……每一家都带 utm_source=scrapling 追踪参数和折扣码。
这不是道德指控,是行业结构说明。 反爬工具的真正瓶颈从来不是代码,是 IP 资源:目标站点封的是 IP 段,不是你的 Python。所以「爬虫框架 + 代理供应商」是天然的利益绑定——框架负责把请求发出去,供应商负责让请求看起来来自不同地方。
看懂了这一层,才能理解 README 里那些措辞的动机:
🕷️ The BEST Web Scraping framework 它使用大量方法…… 让合适的 AI 模型能绕过它遇到的任何 CAPTCHA
「BEST」是自评,「任何 CAPTCHA」是营销。 这类宣称在同类项目里普遍存在,读者需要自己打折。
09 · 三个必须说清的代价
① 合规边界由使用者承担
README 的免责声明写得明确:
本库仅供教育研究用途。使用本库即表示你同意遵守当地及国际数据抓取与隐私法律。作者与贡献者对任何滥用不承担责任。请始终尊重网站的服务条款与 robots.txt。
但功能上是矛盾的:robots_txt_obey 默认关闭,而 solve_cloudflare=True 的存在本身就意味着绕过网站主动设置的访问控制。
这是这类工具的结构性张力:它同时提供「遵守 robots.txt」的开关和「破解 Cloudflare 挑战」的能力,把选择权交给用户。法律风险也就跟着转移给了用户。
对企业使用的实际含义:爬取自有系统、有授权的数据、公开 API 都没问题;爬第三方站点前,先确认 ToS 与当地法律(欧盟 GDPR、中国《数据安全法》都涉及)。
② 单点依赖
94.3% 的代码来自一个人。42 个贡献者里,33 人贡献 ≤2 次。
好消息是 issue 响应快(180 个历史 issue,只剩 10 个 open);坏消息是 Bus factor = 1。这不是「不信任作者」,而是任何生产依赖都要算的风险——尤其当你的爬虫跑在关键链路上。
缓解方式:BSD-3 允许 fork,代码量 630 KB 属于可自行维护的规模。
③ 0.5 版本 + 破坏性变更
v0.5 的发布说明第一句就是警告:
本版本引入大量破坏性变更,无法在此列出。更新前请先阅读迁移指南。
从 0.1 到 0.5,两年 54 个版本。语义化版本在这里只做到 0.x——意味着 API 还在演进,pip install 不锁版本会出问题。 生产环境必须 pin 版本。
10 · 和 Scrapy / Playwright / BS4 是什么关系
不是替代,是收编。
| 你的现状 | 建议 |
|---|---|
| 已有成熟的 Scrapy 项目 | 别迁。Scrapling 提供 @scrapling_response 装饰器,可以让 Scrapy 的 callback 用 Scrapling 的解析器——只换解析层,不换调度层 |
| 只用 BS4 + requests,被反爬卡住 | 这是最该换的场景。StealthyFetcher 直接解决 JS 渲染和指纹问题,解析 API 也兼容 BS4 习惯(find_all('div', {'class':'quote'})) |
| 需要给 AI agent 提供网页访问能力 | 用它的 MCP 服务端,别自己写 |
| 要做大规模分布式爬取 | 看 Scrapy + Scrapy-Redis。Scrapling 的 Spider 是单机并发,不是分布式调度器 |
| 只想解析 HTML,不需要联网 | pip install scrapling 就够了(6 个依赖),或直接用 Selector(html) |
最容易踩的坑是最后一条:很多人以为装了 scrapling 就能用 fetcher,结果 ModuleNotFoundError。解析引擎和抓取引擎是两个安装粒度。
11 · 判断
值得用的场景:
- 中小规模爬取(单机、几十万页以内),不想维护 5 个库的版本冲突
- 目标站有 Cloudflare / 指纹检测,且你有授权
- 要给自己或团队搭一套 RAG 语料
- 给 AI agent 加网页访问能力
不值得用的场景:
- 已有稳定运行的 Scrapy 集群
- 需要分布式调度
- 需要长期稳定 API 承诺(0.x 阶段不适合)
值得读源码的部分(对做工程的人):
- adaptive 的相似度算法(
docs/parsing/adaptive.md+scrapling/parser.py)——把「选择器脆弱性」这个老问题做成了可持久化的工程方案,而不是靠 AI 重新猜。 - 测试的组织方式——99 个测试文件、1.05 MB,比源码多 67%。爬虫库的测试是最难写的,这里值得看它怎么用
-m "browser"/-m "asyncio"分组串行/并行。 - MCP 服务端的动作编排(
scrapling/core/ai/server.py,55 KB)——browser_actions那种「一次调用串起多步、遇错即停」的设计,是 agent 工具接口的一个好范本。
写在最后
Scrapling 的 9.5 万 star,一半来自它确实好用(一个 import 解决整条链路),一半来自它踩中了两个时代红利:反爬军备竞赛和AI 需要网页。
但它的技术含量不在「功能多」——功能多是集成能力,不是壁垒。真正的壁垒是 adaptive parsing:别人都在教 AI 重新生成选择器,它选择把元素特征存进数据库做相似度匹配。 前者每次要花 token 且不可复现,后者一次保存、永久可查。
代价也清楚:一个人写了 94% 的代码,0.5 版本、破坏性变更、默认不守 robots.txt、README 里近半是代理厂商广告。
它现在是一个好用的工具,也是一个值得读的工程样本,但不是一个可以无条件信任的生产依赖。
数据来源:GitHub REST API(2026-11-04),含
/repos/D4Vinci/Scrapling、/commits?per_page=1(Link last page 1786)、/contributors?anon=1(42 人)、/releases(54 页)、/search/issues(issue 180 / PR 305)、/git/trees/main?recursive=1(692 项未截断);PyPI JSON API(0.5,requires_python >=3.10,54 个版本,首个 0.1 / 2024-10-13);pypistats.org(近 1 天 66,033 / 近 7 天 298,235 / 近 30 天 919,855)。文档引文出自README.md(38,299 字节)、docs/parsing/adaptive.md、docs/fetching/choosing.md、docs/ai/mcp-server.md、docs/cli/overview.md、agent-skill/README.md、pyproject.toml、benchmarks.py、tox.ini、.github/workflows/{tests,code-quality}.yml。截图与架构图取自仓库docs/assets/。未验证项:README 声称的 92% 测试覆盖率、与 Selectolax 的实际性能差距(基准只测了 cssselect 路径,197ms 与 selectolax 的通常表现不符,未做独立复测)、
solve_cloudflare对各类 Cloudflare 部署的实际成功率。本文只陈述文档与代码中声明的行为。