先给结论:sweety-handdraw-video 不是"AI 视频生成"项目,它是一条「模型导演 + 本地引擎」的混合流水线——把创作判断交给 Agent,把渲染确定性交给 Python 脚本。 市面上的图生视频方案(Sora、可灵一类)走的是「文本提示 → 扩散模型整段生成」,笔触不可控、内容不可核对、中文字写不出笔顺、画面时间轴对不上旁白。这个项目换了一条路:Agent 负责理解内容、写口播、设计分镜、生成插画;本地引擎负责逐笔描线、按笔顺手写、配音对齐和导出,每一笔的位置和时刻都是算出来的,不是抽出来的。
目录
- 它是什么:一周 715 star 的手绘视频 Skill
- 它解决的问题:手绘视频为什么难
- 五步流水线:从主题到成片
- 预算制分镜:先算画得完,再生图
- 六种导演密度模式
- 像人一样画:运笔的物理常数
- 渲染引擎与字幕硬门槛
- 配音:旁白先行与语义分段门禁
- 21 种画风与六款手臂
- 工程细节:50MB 离线包与镜像修复
- 诚实的边界:它自己写下的限制
- 成熟度评估
- 结语
一、它是什么:一周 715 star 的手绘视频 Skill
一句话:一个安装在 Claude Code / Codex 里的 Agent Skill,输入一个主题、一篇文章或一个完整故事,输出边画边讲的有声 MP4——Agent 当导演,本地 Python 引擎当画手。
数据快照(2026-10-20 通过 GitHub API 与仓库源码核实):
| 维度 | 数据 |
|---|---|
| 仓库 | threerocks/sweety-handdraw-video |
| 定位 | 手绘口播视频制作 Skill(白板动画 / 文章转讲解) |
| Stars / Forks | 715 / 136 |
| Open Issues | 2 |
| 创建时间 | 2026-10-12(至今 8 天) |
| 累计提交 | 76 |
| 最新 Release | v1.4.1(2026-10-19);包内 VERSION 文件为 1.4.1 |
| 许可 | MIT(主项目;内置依赖保留各自许可) |
| 文件总数 | 1,009(其中 skills/ 占 981,即内置依赖与素材) |
| 安装包体积 | 843 个文件 / 49.4 MB(v1.3 实测核验) |
| 宿主与平台 | Claude Code、Codex;macOS 与 Linux(Windows 暂不承诺) |
| 技术栈 | Python 3.9+(Pillow / NumPy / SciPy / fontTools)+ FFmpeg |
| 作者 | leo_xiaolei(X:@leo_xiaolei) |
几个数字值得单独说:
8 天 715 star、76 次提交。这个star 增速在工具类项目里属爆发级别,且迭代极快——10-12 建仓库,10-13 就连发 v1.2.1/v1.2.2/v1.2.3 三个封板,10-17 发 v1.3,10-19 发 v1.4.1。版本号里能看到功能演进:v1.2 封板包含整篇连续旁白和原片参考导入,v1.3 加了声音门禁和素材随包,v1.4 转向原生选项、9:16 竖屏默认和导演密度契约。
1,009 个文件里 981 个在 skills/ 目录——这不是冗余,是它把五个上游项目以固定快照内置了:
| 内置依赖 | 职责 |
|---|---|
sweety-image-art-direction | 主体、接触关系、构图、比例与观看主次 |
hand-drawn-styles | 风格配方、参考锚点与预览 |
omniailab-ai-director | 导演规划、叙事、声画关系与终审方法 |
huashu-art-motion | 适用题材下的艺术动效方法 |
sweety-image-privacy | 图像隐私元数据清理与审计 |
「内置而不安装」是个明确的工程取舍:运行时不自动追踪上游更新,用快照换可复现。README 把来源、许可和固定快照写进了 THIRD_PARTY_NOTICES.md。
三条精选样片(均为 1920×1080、30fps,Release 下载):
| 样片 | 时长 | 风格配置 |
|---|---|---|
| 《那条死于愤怒的蛇》 | 49 秒 | 淡彩叙事插画、毛笔手部、无底板字幕 |
| 《快乐囚禁你的方式》 | 1 分 52 秒 | 冷色棱角插画、女性手部、连续女声旁白 |
| 《墨菲定律》 | 约 2 分 05 秒 | 淡彩速写、碎钻长甲手、笔杆文字;8 个画面、24 段口播 |
二、它解决的问题:手绘视频为什么难
要理解这个项目的设计选择,先得看清「让 AI 做手绘讲解视频」这件事难在哪。三条路线各有各的坑:
| 路线 | 问题 |
|---|---|
| 图生视频模型(Sora / 可灵类) | 笔触是"抽"出来的,不可控、不可核对;画面时间轴对不上旁白;中文按笔顺书写基本无解 |
| 通用动画软件 + 手动 K 帧 | 一条两分钟视频要 K 几百个关键帧,改一句话全部重来 |
| 开源白板动画工具(VideoScribe 类) | 模板化、素材库封闭,做不了内容驱动的定制插画 |
这个项目的答案是把流水线切成两半:
关键在于分工边界:模型负责"画什么、讲多久、用什么风",脚本负责"画得完画不完、运笔像不像人、字幕压没压图"。SKILL.md 里有一句话把这份分工写得很直白:
主体内容由模型设计;脚本只执行已确定的素材与时间线,并用客观指标拦截错误。
翻译成工程语言:模型是创作者,脚本是护栏。护栏不创作,只拦截——旁白没锁不给渲染、分镜没算预算不给生图、线稿门槛不过不给编排、检查记录过期不给交付。这套边界感是后面所有机制的前提。
三、五步流水线:从主题到成片
完整流程在 SKILL.md 里固化为六步,我按数据流重新画了一遍:
两个反直觉的顺序值得注意:
声音先于画面。 不是先出图再配音,而是先写完整口播稿、逐段合成、拼成母带、生成 alignment.json 逐句时间戳——然后用时间戳反推每幅画能画几秒。这解决了手绘视频最经典的死局:画面画完了,旁白没说这么长。
生图前先算账。 分镜按旁白算出每个 visual 的绘制窗口和笔数上限,图按预算设计。约 3 倍人速画得完就停,笔忙占比受模式约束且不超过 70%。画不完的图不是渲染时压缩时间轴(那会变成"快进糊弄"),而是上游简化图片或把窗口跨句延长——storyboard_lint.py 里对"引擎超预算"是直接判 error 的:
if asset.get('time_compression', 1) > 1.001 or ... speed_over_cap or ... fill_over_cap:
    errors.append(f'{label}: the engine exceeded its drawing budget; simplify the image or extend its window across beats instead of compressing its strokes')
四、预算制分镜:先算画得完,再生图
这是整个项目里我最欣赏的部分,也是它与"AI 生成视频"拉开本质差距的地方。核心问题一句话:给定一段真实时长的旁白,每幅图能画几秒、能画几笔? storyboard_lint.py(479 行)把这个问题做成了可执行的门禁。
4.1 绘制节奏的标定常数
STROKES_PER_SECOND = 3.5  # measured draw-v2 pace at the cap: contour strokes, pen lifts and marker color included
MAX_DRAWING_SHARE = .7    # the pen is busy at most this share of the narration
3.5 笔/秒不是拍的脑袋——注释写明是 draw-v2 引擎实测节奏,且轮廓笔、抬笔移动、马克笔上色都算笔数。70% 是笔忙占比上限:剩下的 30% 必须留给观众看完成图。这两个数决定了后面所有的分档和窗口计算。
4.2 按秒数分档的复杂度契约
def tier(seconds, hold):
    strokes = max(3, int(seconds * STROKES_PER_SECOND))
    if seconds < 3:
        return f'label or tiny icon: at most ~{strokes} strokes'
    if seconds < 6:
        return f'simple icon/silhouette: at most ~{strokes} strokes, flat fills'
    if seconds <= hold:
        return f'one subject: at most ~{strokes} strokes, flat fills, no texture lines'
    return (f'at most ~{strokes} strokes: a scene with background ... or split into two visuals')
一幅图能画几秒,就只允许几笔——不到 3 秒的窗口只配画个小图标或标签,超过单镜停留上限的要么画带背景的场景(靠部位分节拍撑时间),要么拆成两幅。复杂度不是美术喜好,是时间预算的函数。
4.3 窗口与视觉数量:两条硬公式
每个 visual 的绘制窗口这样算:
cursor = start + LEAD                                              # LEAD = 0.54
window = times[shot['beats'][-1]]['end'] - HOLD - cursor - GAP * max(0, len(visuals) - 1)   # HOLD = 0.6, GAP = 0.08
seconds = window * weight / sum(weights)
即:镜头内首 beat 起点 + 0.54 秒起笔,末 beat 终点前留 0.6 秒收尾,多个 visual 之间留 0.08 秒抬笔间隔,剩余时间按权重分配。窗口不足 0.5 秒直接报错:「only Xs to draw; give the shot more beats or fewer visuals」。
全片视觉数量也有下限:
required = max(1, math.ceil(narration / hold * rules['cadence_factor']))
旁白总时长除以单镜停留上限再乘模式系数——信息密度不够会被拦,而且报错信息直接告诉你该往哪加:
3 planned visuals for 92.0s of narration; at least 12 are needed (a new visual every 8s).
Add visuals to the sparsest shots: shot_07 (14.2s per visual), shot_03 (12.8s per visual) ...
插画占比也有要求:图片数少于 0.8 × required 且没写 text_only_reason 时判错;纯文字镜头超过 20% 时长同样拦。宿主没有生图能力时必须停下告诉用户,不允许静默降级成"文字滚动视频"——这条写在了错误信息里。
4.4 成片后的三项节奏复核
预算检查只是"计划",渲染完还有"实测"三件套:
| 指标 | 门槛 | 含义 |
|---|---|---|
pen_busy_share | ≤ 70%(模式可更严) | 笔在画的时间占比,含抬笔;超了说明完成图留不出阅读时间 |
finished_picture_hold_share | ≥ 30% | 完成图的静态阅读时间占比;不含片头空白和结尾静音 |
| 最长静止段 | ≤ max_hold_seconds | 超过 hold 秒"什么都没画"直接报错,要求拆镜或加视觉 |
还有一条防偷懒的:同一张主图连续占超过 2 个 beat 会被拦,除非该镜标注了 callback 并写明理由。完成图停留时间的中位数低于模式要求会警告,单幅低于 1 秒也警告——注释里给了标定基准:「the first Codex film held only 0.56s on average, validated films hold 1.1-1.7s」。
4.5 镜头类型不是随便填的
七种 shot type 各有结构化真值条件,编剧意图要过代码校验:
SHOT_TYPES = {
    'scene_with_background': (lambda visuals: any(v.get('kind')=='illustration' and v.get('background') for v in visuals)),
    'comparison': (lambda visuals: sum(v.get('kind') in PICTURES for v in visuals) >= 2),
    'character_action': (lambda visuals: any(v.get('kind')=='illustration' and v.get('characters') for v in visuals)),
    ...
}
声明了 comparison 却只放了一幅图、声明了 character_action 却没有登记角色——都会被拦。角色必须绑定锁定参考图 + SHA-256,且绘制计划里要引用该参考图,防止跨画面角色漂移。
五、六种导演密度模式
v1.4 引入了 presentation.mode——这不是用户选项,是导演根据受众和内容推断的密度契约,写在 design.json 和 storyboard.json 里,由 storyboard_lint.py 强制执行。六种模式的参数差异很大:
| 模式 | 密度 | 单镜停留上限 | 视觉节拍系数 | 每镜图片上限 | 每镜标签上限 | 板复用 | 笔忙占比 | 完成图中位停留 |
|---|---|---|---|---|---|---|---|---|
picture_book | 稀疏 | 10s | 1.35 | 1 | 2 | 否 | 55% | ≥ 2.0s |
focus_diagram(默认) | 中 | 8s | 1.0 | 2 | 5 | 否 | 70% | ≥ 1.2s |
dense_infographic | 密集 | 7s | 0.9 | 4 | 12 | 是 | 70% | ≥ 0.9s |
accumulating_board | 密集 | 12s | 0.55 | 6 | 16 | 是 | 70% | ≥ 0.8s |
step_sequence | 中 | 8s | 1.05 | 1 | 3 | 否 | 60% | ≥ 1.3s |
narrative_comic | 中 | 8s | 1.1 | 3 | 4 | 否 | 60% | ≥ 1.4s |
几个设计细节:
accumulating_board(黑板报模式)的 cadence_factor 只有 0.55——同一块板跨 beat 累积,不需要每句重画整页,所以"每 hold 秒一幅新图"的要求减半。它还要求整页先规划 boards 的区域位置,同一块板在一张物理页面上按阅读顺序逐项补齐,不每句话清场。这是从"白板动画"向"课堂板书"的关键扩展。
模式必须带 reason。validate_presentation() 强制要求解释为什么这个模式适合受众和内容,density 字段还必须与模式内置值一致——想手动把 picture_book 标成 dense 会被拒。
模式是推断出来的,不是问出来的。infer_hints() 给模型的先验很直白:儿童叙事走绘本、单概念深挖走焦点图、清单对比走信息图、连续板书走黑板报、操作流程走步骤序列。用户不选,模型按内容定。
六、像人一样画:运笔的物理常数
如果说预算制分镜保证了"画得完",line_drawing.py(306 行)保证的就是"像人在画"。它的做法是把拟人感拆成一组可标定的物理常数:
| 常数 | 值 | 含义 |
|---|---|---|
LINE_SPEED | 420 px/s | 1080p 下人类描一条自信轮廓的笔速 |
SPEED_FACTOR | 4 | 倍速标定:4–8 倍速的快手视频仍读作人类,前提顺序连贯 |
VIDEO_LAPSE | 3.0 | 约 3 倍人速画完就停,绝不慢放填充窗口 |
FRAME_PX | 80 px | 描线笔尖单帧最大位移,超过就不像连续运动 |
TRAVEL_PX | 120 px | 抬笔移动的单帧峰值,防"瞬移" |
DETAIL_BOOST | 1.6 | 细节和短标记允许比主笔快 1.6 倍 |
PART_PAUSE | 0.18 s | 语义部位之间的思考停顿(随倍速缩放) |
REVERSE_COST | 250 px | 右手偏好:宁可多绕 250 px,也不向左/向上画 |
这组常数撑起了几个具体的拟人机制:
转弯自动减速。 弧长计算不是欧氏长度,而是按曲率加权——steps * (1 + 1.5 * clip(turn / (π/8), 0, 1)),转弯处弧长膨胀,笔尖在曲线和拐角自然放慢。转角用 ±6 px 窗口测量,防止骨架像素抖动被误判为弯曲。
右手方向偏好。 REVERSE_COST = 250 的注释写得很直白:「px of extra travel a right-hander accepts rather than draw a line upward or leftward」。路径规划时,向左或向上画一笔要计入 250 px 的额外代价——于是笔画方向整体呈现出右手绘制的顺手感。倍速顶上还有个 HURRIED = REVERSE_COST / SPEED_FACTOR = 62.5:手快到顶上时,方向偏好让步于速度。
两种速度剖面。 stroke_profile() 按笔画长度和人速倍率切换:长笔画在倍速模式下用 plateau(两端缓入缓出、中间巡航),短笔画用 min-jerk。lift_seconds() 算抬笔时间——人类节奏 80–150 ms,随墨迹同步倍速,2 帧保底,且要满足抬笔移动的帧内位移不超 TRAVEL_PX。
部位分级与停顿。 笔画按 SILHOUETTE / KEY / STRUCTURE / DETAIL / TEXTURE 五档归类(KEY_PART 正则认 head/face/eye/mouth/nose/hand/finger/paw 这些关键部位),每个语义部分先轮廓后细节,部分之间停 0.18 秒——像人画完一个部分停下来想下一步。注释里给这部分的总纲是:
Order, time and render whole line strokes like a right-handed person: per part the silhouette first, then long interior structure, then details and short marks.
七、渲染引擎与字幕硬门槛
video_renderer.py(529 行)负责把时间线渲染成帧:手部合成、路径文字、马克笔运动、水印。几个细节见功力:
手腕倾角上限 7 度(MAX_TILT = 7)——手臂跟随时加一点手腕转动,但不许过,过了就是"橡皮手"。阴影方向统一为向右下(SHADOW_DIRECTION = (0.555, 0.832),光源在左上),连笔杆阴影都按笔尖起算、随 barrel 距离漂移(PEN_SHADOW_SLOPE = 0.2)。手臂进出场 0.45/0.5 秒、镜头停留 1 秒——短于 1 秒的抬笔间隔会让手"留在画面里抢戏"。
每个像素都有语义归属。 质量门禁要求每个插画像素归到具体部位,所有轮廓结束后才填色,且两个阶段按同一部位顺序。部位审查还要处理遮挡关系——「发丝间露出的伞面属于伞,手持物不属于手臂,包与腿相交处按实际前后关系分配」。程序只能验证给定归属的执行顺序,不能证明模型分区语义正确——这句自我认知也写进了文档。
字幕唯一性是交付硬门槛。 同一句旁白同一时刻只允许一份字幕:画面烘焙、字幕事件、MP4 内嵌轨、网页 <track>、播放器自动加载,五条路都不许叠加。build 时就检查字幕避让——插画像素不得压进字幕区(含边距),不等渲染后才发现。编辑用字幕只能放 outputs/editing/。交付时检查成片无额外字幕轨、同目录无 SRT/ASS/VTT,并实际看解码画面的长句、换句和片尾。
检查记录分三层,不许互相顶替。 review.json 里工程检查(verify)、观感检查(visual / motion / content)、连续播放和实际听音分别记录。continuous_playback 和 listening 只能是 pass 或 not_done(写原因),做了 ASR 不等于听过——文档原话:「若只检查了 ASR,不能写’已经完整听过’」。抽帧能验证字形和版面,不能单独证明全片运动流畅。用户拒绝成片有专门命令:handdraw_video.py reject JOB --reason "用户原话",回执改为"用户已拒绝,需要返工",这一版不能再 finalize。
八、配音:旁白先行与语义分段门禁
声音在这条流水线里是时间轴的主锚,所有画面节奏都由它倒推。管线设计:
几个关键决策:
按语义分段,每段不超过约 100 字,只在句末切。 不按标点硬切、不跨句合并——保证每段的韵律完整,重读某句时只重新生成变化的语义段落。
每段过噪声门禁才保留。 嗡声、底噪、削波三项,不通过就换种子重试。这不是矫情——样片《那条死于愤怒的蛇》原版旁白带 235 Hz 嗡声,v1.3 门禁会直接拦截。拼接母带时用实测停顿,禁止"一律删静音、缩短所有停顿或全片交叉淡化"来掩盖错误,真实换气和语义停顿要保留。
四类配音后端,音色与后端分离:
| 路径 | 说明 |
|---|---|
| VoxCPM2 本地适配器 | Apple Silicon + MLX;项目用 VoxCPM2-8bit,权重约 3.23 GB |
| VoiceStudio 本机服务 | 默认 http://127.0.0.1:3900,已对接 Qwen3-TTS-12Hz-1.7B-Base-bf16 |
| 现成整篇旁白 | 离线编排渲染,不重新合成 |
| 火山豆包 / Gemini TTS | 用户自带密钥,非默认路径(只做过模拟 HTTP 测试) |
六款声音里四款随包合成(磁性解说男声为默认、儒雅青年、温柔知性女声、悬疑故事解说),逼真男声/女声沿用原片参考、需用户自行导入。随包合成声音由本机 VoxCPM2 仅凭文字描述设计,未使用真人/主播/平台音色作参考;用户导入声音要声明授权(consent: self / consent: authorized),不克隆公众人物音色。作者本机环境是 M3 Max / 36GB——这是跑 3.23 GB 模型的家底,换个 8GB 的机器这条路直接不用考虑。
改一句话不必全部重做。 只改字幕/笔杆/水印/布局可复用图和声音;改口播正文只重新生成变化的语义段落。但改旁白后必须重算画面和字幕——「不能让视频页面成为声音切口」。
九、21 种画风与六款手臂
画风库是 20 个编号风格 + 一个稳定变体,按绘制方式分两类:
逐笔绘制(先描线后上色):编号 1、4、5、17、19、20——清晰墨线轮廓 + 平涂,这也是没有指定画风时模型默认挑选的范围。
揭示模式(笔带宽软笔刷按部位扫出成图):其余画风——只能由用户明确接受(reveal_accepted),因为"刷出来"和"画出来"是两种观感,不能替用户决定。纯黑白的 1 号要写明理由才用。
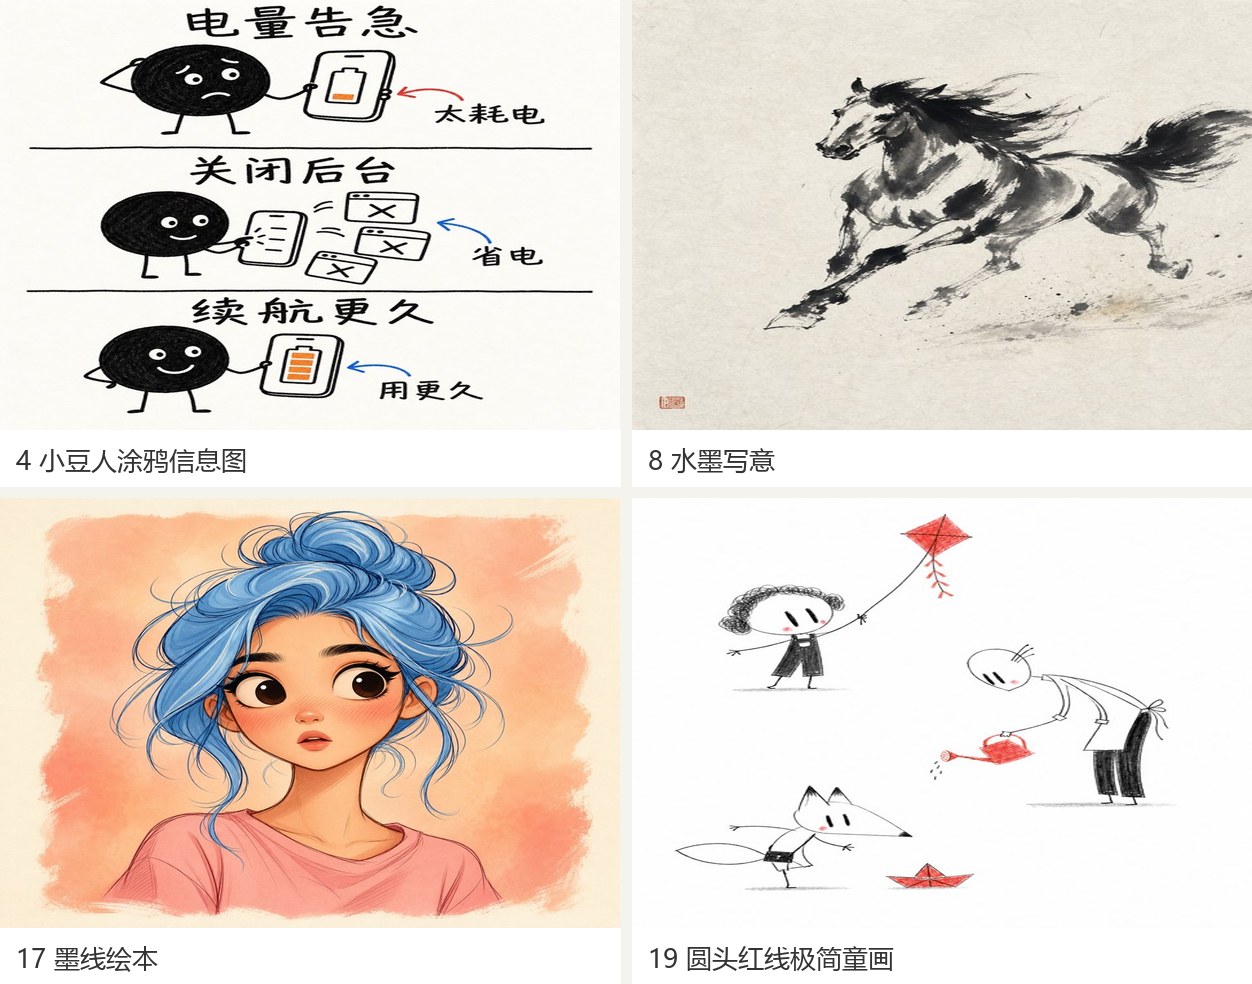
选择方式有四种:直接看预览选编号、库内自动匹配、模型独立设计(线条/颜色/明暗/材质/背景全自定义)、用户描述方向。风格选择器直接读包内预览,不访问网络——这是 v1.3 把 21 张预览图随包分发的原因。
六款手臂预设按笔尖到手腕校准,裁切边留在画外:
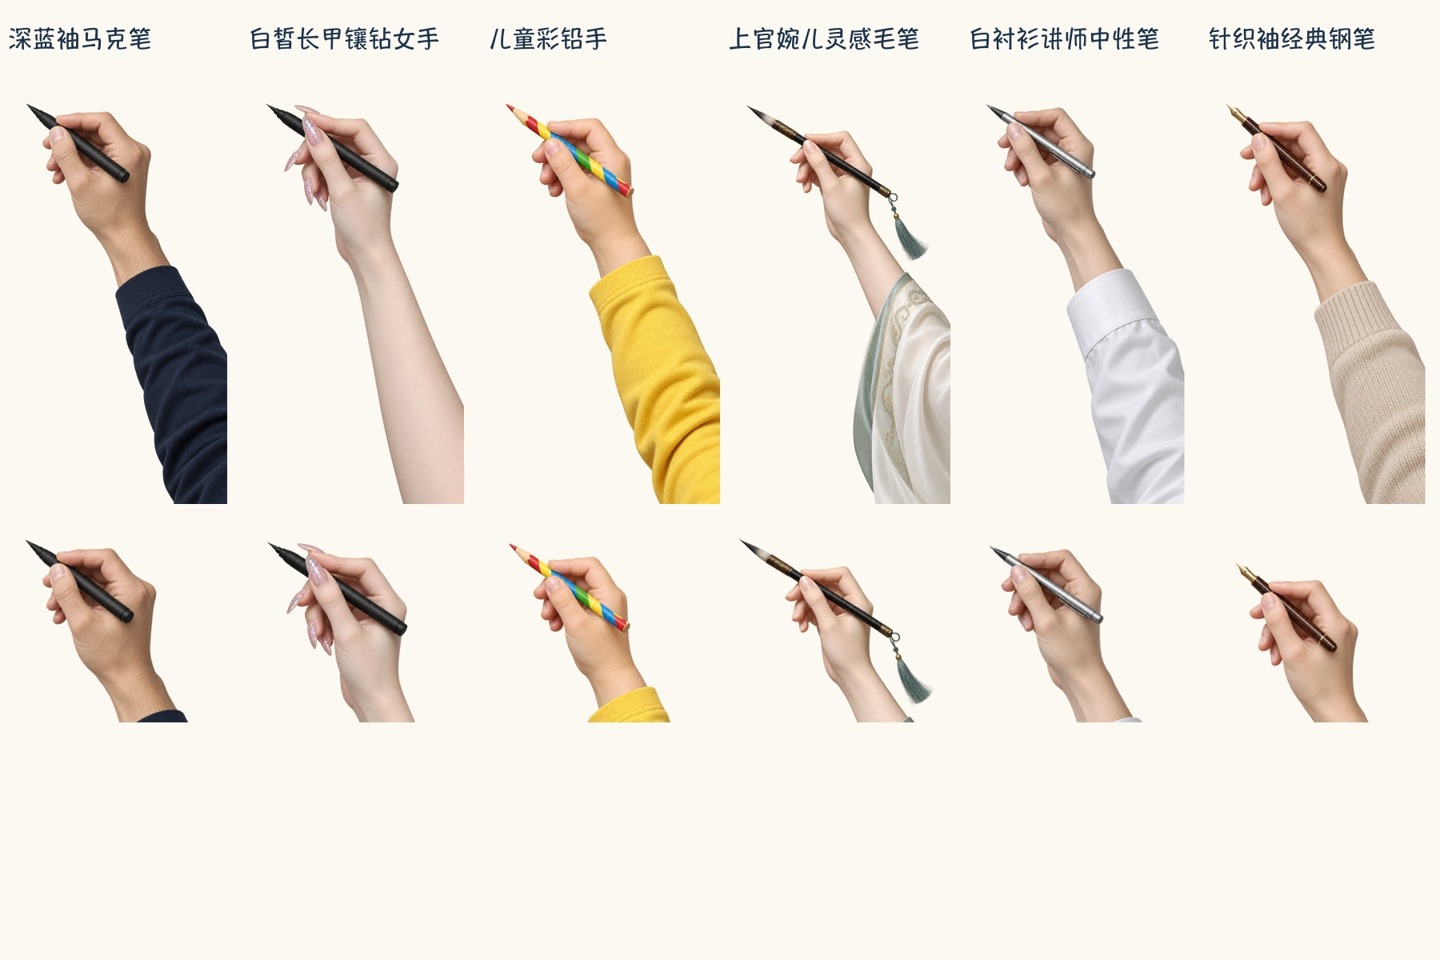
| 预设 | 标识 | 笔 |
|---|---|---|
| 深蓝袖马克笔 | navy | 马克笔 |
| 女性柔粉碎钻长甲 | diamond-woman | 同上笔型女性手 |
| 儿童彩铅 | child-pencil | 彩铅 |
| 上官婉儿灵感毛笔 | waner-brush | 毛笔 |
| 白衬衫中性笔 | teacher-pen | 中性笔 |
| 针织袖钢笔 | cardigan-fountain | 钢笔 |
| 仅画笔(无手臂) | pen-only | navy 同款笔去掉手臂 |
笔杆文字最多 16 个 Unicode 字符、水印最多 180 字符可换行——默认都不加。这两个选项本质是给做号的人留的商业化口子,作者没有默认塞广告。
十、工程细节:50MB 离线包与镜像修复
这个项目的工程质量不止在渲染管线,也在分发和资产完整性上。几个机制值得单独看:
10.1 安装体积的硬预算
validate_package.py 把「二进制文件禁令」换成了更实用的预算制:安装包总量 ≤ 50 MB、单文件 ≤ 10 MB,且包内预设必须与清单记录的哈希一致。v1.3 实测 843 个文件 / 49.4 MB 通过——贴着上限走,说明作者在主动管理体积。
同时按 omitted_showcase_media 机制移除了 omniailab 导演依赖里的 examples/motion 和 examples/images 宣传示例(533 个文件),方法文档和运行代码保留。README 特意说明:减小代码包不等于清理 Git 历史,没有改写历史提交。
10.2 资产修复:四级回退与哈希校验
手部、画风预览、试听共 30 个文件(约 8.8 MB)随包分发,hosted-manifest.json 为每个文件记录字节数、SHA-256 和有序镜像地址(jsDelivr CDN → Fastly → GitHub Release)。读取顺序:
三个细节:只有大小和哈希都一致的内容才写入缓存,不会"退回另一张图或另一种声音";HANDDRAW_OFFLINE=1 跳过联网直接说明缺失文件;HANDDRAW_MIRROR 支持 file:// 前缀——内网/Gitee 镜像可以顶上去。
10.3 一次真实的图床迁移
README 记录了一次值得写进教科书的资产运维事故:内置画风库的参考图原托管在 Netlify,额度耗尽停用,75 个链接变死链。修复方案是把链接整体迁到 jsDelivr 并固定到上游含图提交 cdfd004c89164096c861ad06ebab2aa1527d1710,Release 附件作最后回退。还有个更细的处理:五张运行参考锚点里三张清理了来源与模拟相机字段(逐像素一致),jsDelivr 返回上游原字节时校验不符,会自动转用 Release 清理版——清单保留上游字节校验值以便追溯。这种"清理过隐私的资产和上游原字节不一致"的边界情况,大多数项目到死都不会遇到。
10.4 纯 Python 隐私清理
图片隐私清理(clean_image.py)从原来的 Bun + ExifTool 改成纯 Python 实现——少两个外部依赖,setup.sh 也少两样要装的东西。所有生成图都要过这一步,元数据与来源属性分别报告,且文档明确:隐私处理不等于 AI 检测保证。
10.5 测试与验证
v1.3 记录:158 项回归通过(1 项平台用例跳过)、离线冒烟短片通过、安装包 843 文件 49.4 MB 通过核验。scripts/ 下 71 个文件里 test_*.py 有 30 个——对一个 Skill 项目来说测试密度相当高,且 smoke_test.py 可以离线跑通整条渲染链。
十一、诚实的边界:它自己写下的限制
这个项目的文档质量里最难得的,是把边界写在明面上:
| 边界 | 原文口径 |
|---|---|
| 平台 | macOS 与 Linux;Windows 暂不承诺;宿主限 Codex 与 Claude Code |
| 生图能力 | 宿主无法生成图片时必须停下说明,不能交付只有文字的视频 |
| 稳定性 | 不承诺任意主题一次稳定生成 |
| 笔顺范围 | GB2312 范围内汉字按标准笔顺,其余字符按字形描线 |
| 耗时与费用 | 作者自述两分半样片"差不多 10 分钟"、200 美元订阅环境"不到 1%"——特定账号自述,非统一计量 |
| 橡皮擦转场 | 无交付证据,不列为现成功能 |
| AIGC 标识 | MP4 已写入隐式标识,发布时仍须按平台规则声明"AI 生成" |
| 声音验收 | ASR 正确 ≠ 听感好;无听音工具时必须在交付说明里保留"主观听感未验收" |
| 系列批量 | 可固定画风配方和角色锚点,但仍可能漂移,每条都要检查 |
还有一条容易被忽略的:脚本不能替代观看。文档反复强调「最终实际画面仍须检查,不能以程序检查替代观看」「工程能约束检查是否完成和证据是否对应当前图,不能自动理解’切断’」。叙事事实甚至要做进图里——《蛇》样片的"身体切断"必须在 drawing-plan 里列为 narrative_requirements,要求两处可见空隙与断开的蛇段,看图时按相同 id 记录证据。把"剧情真实性"做成可勾验的契约,这是我对这个项目印象最深的细节之一。
十二、成熟度评估
| 维度 | 评价 | 依据 |
|---|---|---|
| 概念完整度 | 高 | 主题/文章/故事/定稿四类输入都有明确处理规则,修订可分层复用 |
| 工程严谨度 | 高 | 预算制分镜、拟人运笔常数、哈希资产校验、版本封板记录,都是踩过坑的正解 |
| 文档质量 | 很高 | SKILL.md + 14 份 references,限制和代价写在明面上,不营销 |
| 测试覆盖 | 中高 | 158 项回归 + 冒烟短片 + 打包核验;但完整制作实测仅来自 macOS + Codex |
| 平台覆盖 | 中 | 明确不支持 Windows;Claude Code 侧"整片流程待实测" |
| 社区活跃度 | 高 | 8 天 715 star / 136 fork / 76 提交,作者在 X 持续更新 |
| API 稳定性 | 中 | 自我标注 dev;本地 1.3/1.4/1.4.1 曾为未公开迭代号,公开标签后置对齐 |
| 主观质量保证 | 无 | 观感、听感、学习效果明确不承诺,检查记录分层留痕 |
一句话:这是一个"作者自己天天在做片"的项目。判断依据不是 star 数,而是那些只有真正做过片才会加的机制——3.5 笔/秒的标定(被画不完的图坑过)、235 Hz 嗡声门禁(被样片杂音坑过)、Netlify 死链迁移(被图床坑过)、字幕唯一性硬门槛(被双字幕坑过)、“做了 ASR 不等于听过”(被自己的验收记录坑过)。每一条都对应一次具体的翻车。
十三、结语
回到开头那个判断:它把"AI 做视频"从生成问题重构成了约束满足问题。
图生视频模型的范式是"生成然后祈祷"——抽一笔、看结果、不对再抽。这个项目的范式是"先算账再动手"——旁白时长决定绘制窗口,窗口决定笔数上限,笔数决定图片复杂度,复杂度决定生图提示词。渲染引擎只执行已验证可画的计划,预算不够就在上游改分镜,绝不靠压缩时间轴糊弄。确定性不是从模型里榨出来的,是从流水线的结构里长出来的。
但它真正值得学的地方,是那份贯穿所有文档的分工自觉:模型该做的(理解、创作、判断)和脚本该做的(标定、拦截、核验)划得很清,而且双方都不越界——脚本不假装能审美,模型不假装能保证。放到更大的语境里,这其实是所有 Agent 产品都要回答的问题:当执行者是不可靠的智能体时,工程系统的价值就在于把"不可靠"约束在可验收的边界内。
对普通读者,它的实用价值也很直接:有一条两分钟的知识讲解/寓言故事/产品原理要做口播视频,又不想出镜、不想 K 帧、不想学动画软件——装个 Skill,把文章丢给 Agent,喝杯咖啡回来审片。macOS 用户现在就能试;Windows 用户(比如我)只能等,或者去催作者。
承认自己做不到什么,比宣称自己什么都能做,更能建立信任。 这条在工程上和在别处一样成立。
免责声明:本文基于 2026-10-20 的仓库快照(
main分支、Release v1.4.1)与公开源码、SKILL.md、references 文档及 GitHub API 数据撰写,所有代码片段与常数均可在仓库skills/sweety-handdraw-video/scripts/核对。文中「实测」指作者记录的 v1.3 验证结果(158 项回归、843 文件 49.4 MB 安装包等),非本文在本机复跑;本文未在 macOS 环境实际制作视频。项目仍在高速迭代,接口、默认值、支持平台均可能变化,使用前请以仓库最新 README 与 SKILL.md 为准。文中引样的星标、提交数等动态数据随时间变化。本项目涉及本地运行第三方 TTS 模型与声音素材,声音授权与平台 AIGC 声明规则请自行确认遵守。