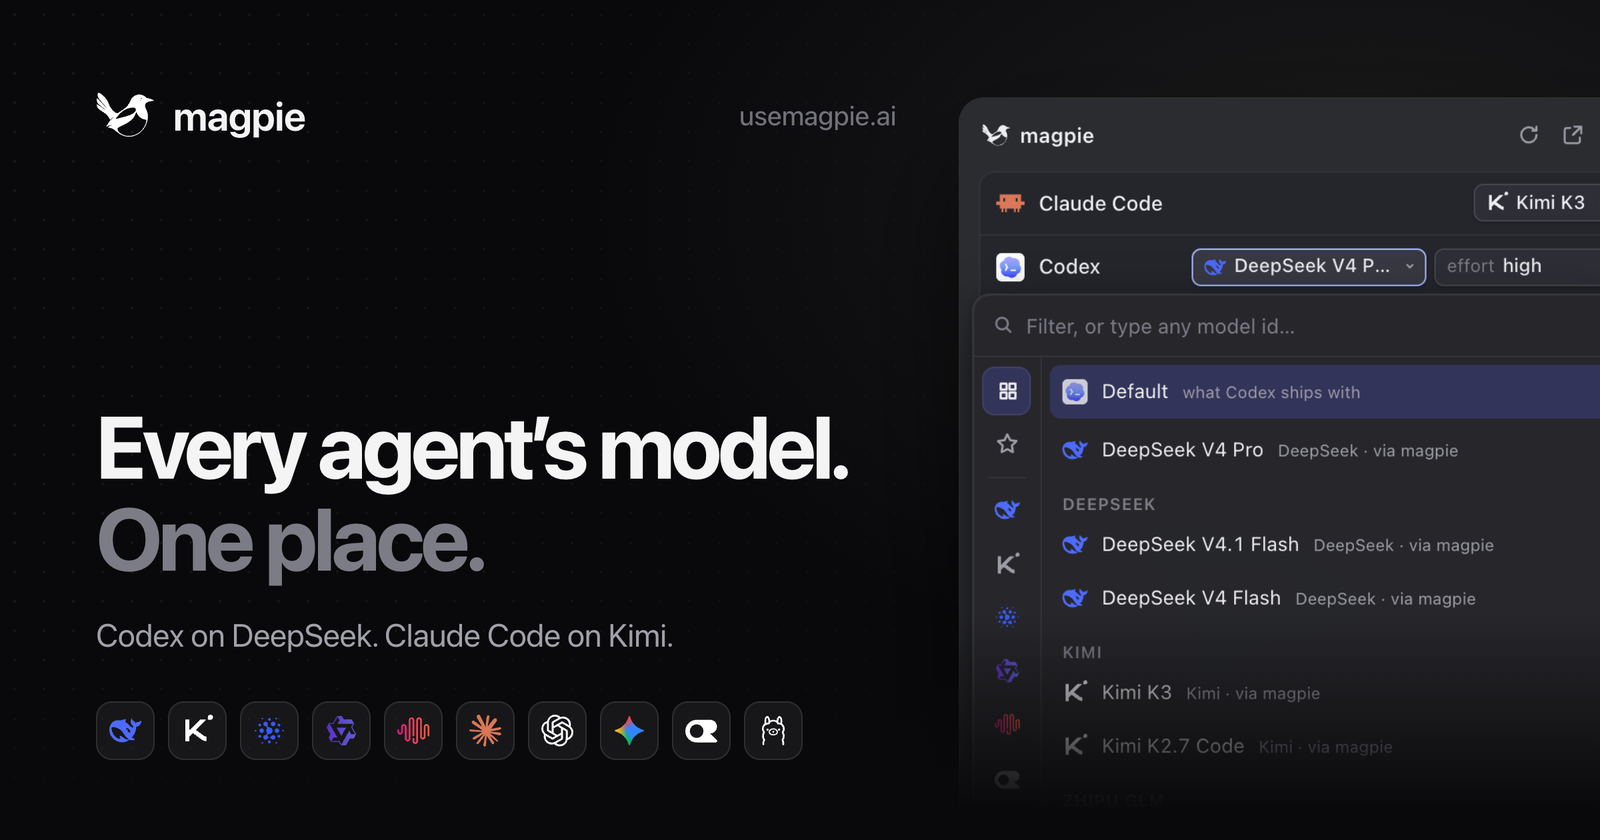
先给结论:magpie 不是又一个 LLM API 客户端,它是 agent 时代的「统一适配层 + 配额调度器」。 当你同时用着 Claude Code、Codex、Gemini CLI,手里握着两三个付费订阅和一串 API key,magpie 把它们收敛到本地一个网关后面:agent 随便挑,模型随便换,谁配额撞墙了自动切下一个,agent 全程无感知。这个项目的作者是 yetone——Neovim 社区里 avante.nvim 的作者,以一人主导 + AI 军团协作的方式高频推进,工程纪律之严在同类项目里少见。
目录
- 它解决的真问题:agent 碎片化与订阅孤岛
- 整体架构:一个网关,两种改写
- 四协议互转:一个端口讲四种「方言」
- 配置改写器:动你的配置文件,但不动你的格式
- 订阅复用:把 Claude 订阅喂给 Codex
- Routing Groups:配额撞墙自动切换的核心
- Intent Routing:让小模型决定这轮该花多少钱
- 插件系统:跑在 Bun 上的网关中间件
- 用量、成本与周边能力
- 工程治理:LESSONS.md、破坏式测试与不收 PR
- 适用、不适用与风险
- 成熟度评估与结语
一、它解决的真问题:agent 碎片化与订阅孤岛
2025 年之后,AI 编程工具的生态不是「一个 IDE 一个助手」,而是一排 CLI agent 并存:Claude Code 写重构、Codex 跑长任务、Gemini CLI 吃免费额度、Cursor CLI 在项目里做杂活、Cline 留在 VS Code 里。每个 agent 都把模型配置存在自己的文件里、用自己的格式、配自己的 key 和 base URL。
这带来三个具体的疼:
- 配置孤岛:想让所有 agent 都切到新出的模型,要改五六个配置文件,格式还各不相同;
- 订阅孤岛:你付了 Claude Pro、ChatGPT Plus、Copilot Pro,但每份订阅只能在自家的客户端里用,跨不过去;
- 配额撞墙:Claude Code 跑大任务撞到 5 小时窗口上限,只能干等或者手动换 key、换环境变量,上下文还断了。
magpie 的回答是一个跑在本机菜单栏里的常驻应用 + 一个监听 127.0.0.1:3425 的本地网关。口号很直白:“Every agent’s model. One place.”——Claude Code 跑 Kimi、Codex 跑 DeepSeek、Gemini CLI 跑 GLM、OpenCode 用你的 ChatGPT 订阅,都在一个地方配。
二、整体架构:一个网关,两种改写
magpie 的结构可以拆成两半理解:**朝南(对 agent)**是配置改写器 + 多协议网关,**朝北(对模型)**是 provider 抽象 + 订阅桥接 + 路由调度。
两条关键路径:
- 配置改写路径:magpie 直接改 agent 自己的配置文件(比如 Claude Code 的
~/.claude/settings.json),把 base URL 指向本地网关、注入凭证。agent 启动时以为自己在连官方,实际请求进了 magpie; - 请求转发路径:agent 发出的请求进网关,经插件中间件、路由组调度,最终发往某个 API provider 或某个订阅账号的会话。
形态上它覆盖了几乎所有入口:macOS/Windows/Linux 菜单栏应用、独立窗口、TUI、Web UI、CLI,另有 Docker 镜像(distroless、multi-arch)和 Termux 支持。Windows 下连 WSL 里跑的 agent 也能接。
三、四协议互转:一个端口讲四种「方言」
网关层最吃工程功力的部分在这里:同一个 3425 端口同时讲 OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、Google Gemini 四种协议,并且双向互转——流式 chunk、tool call、reasoning content 都要在翻译中不丢语义。
这件事的价值在于:agent 不需要「被适配」。任何支持自定义 base URL 的工具,只要设
OPENAI_BASE_URL=http://127.0.0.1:3425/v1
就能接进来,哪怕它只会说 OpenAI 方言,而背后真正接的是 Anthropic 协议的账号。市面上靠协议转换起家的项目(one-api、new-api、LiteLLM)都做过类似的事,但多数只覆盖 OpenAI/Anthropic 两家,把 OpenAI Responses 这个新协议和 Gemini 也纳入双向转换矩阵的,magpie 是第一个做到这么全的。
模型目录也不用自己维护:provider 列表预置得极全(Anthropic、OpenAI、Google、Vertex、Bedrock、DeepSeek、Kimi、智谱 GLM、MiniMax、StepFun、Qwen、火山 Ark、Mistral、Groq、xAI、OpenRouter、Together、Fireworks、SiliconFlow、Ollama、LM Studio……),模型清单来自厂商接口 + models.dev 补全,新模型发布当天刷新即得。
四、配置改写器:动你的配置文件,但不动你的格式
这是一个看似不起眼、实际很见功力的子系统。magpie 切换「Claude Code 用 DeepSeek」时,不是生成一份新配置覆盖掉你的文件,而是原子化地改写配置里对应的那几个字段,并且明确承诺:保留注释、保留键的顺序、保留原有格式。
这意味着:
- 你在配置里写的注释、自定义 header、其他无关配置不会丢;
- 反复切换模型不会让文件越来越脏、最后没法 review;
- 切回官方端点是可逆的,magpie 知道自己改了什么。
它还会只显示你机器上实际安装了的 agent——60+ 的兼容列表(Claude Desktop、Codex、VS Code Chat、JetBrains、Zed、Crush、Kimi Code、Qwen Code、Cline、Devin、Goose……)不是营销清单,而是扫描本机安装状态后动态呈现的。
另外有 Profiles 概念:把整套 agent 配置存成一组(比如 “Budget” 全走便宜模型、“Focus” 全走顶配),一键切换。
五、订阅复用:把 Claude 订阅喂给 Codex
magpie 最有争议、也最独特的能力,是把订阅账号变成 provider:
- 通过登录桥接复用你已付费的 Claude、ChatGPT、Copilot、Gemini、Grok 订阅会话;
- 这些会话在网关里被抽象成普通的上游凭证,可以分配给任何 agent;
- 甚至有 Daily warm-up:定时启动账号产生活动,把 Claude 式的「5 小时滚动窗口」配额尽量用满。
仓库 docs/subsystems/ 下专门有一篇 claude-subscription-bridge.md 讲这个子系统,说明它不是逆向个接口就完事的玩具,而是被当作正式子系统设计的。
价值显而易见:一份 ChatGPT Plus 的月费,理论上能同时供给 Codex 之外的所有 agent 使用。但这也是整个项目风险最高的部分——它踩在各家订阅条款的灰色地带上,账号风控、会话失效、甚至封号都是使用者要自己承担的成本。这一点放到第十一节展开。
六、Routing Groups:配额撞墙自动切换的核心
如果只能选一个 magpie 的「杀手特性」,是 Routing Groups。
你可以把多个模型 / 多个账号打包成一个逻辑端点 group/xxx,agent 只认这个组名,magpie 在组内按策略调度。五种模式:
| 模式 | 行为 | 适合场景 |
|---|---|---|
smart | 优先用配额窗口最快重置的订阅,减少浪费 | 混合订阅 + API,追求不浪费 |
order | 严格按顺序,前一个失败才 fallback | 有明确主次偏好 |
rotate | 每轮对话轮换一个上游 | 均匀摊薄用量、养号 |
usage | 历史用量最少的优先 | 多账号公平消耗 |
pace | 按各账号剩余配额比例分配 | 窗口期内匀速跑完所有额度 |
当上游返回配额 / 风控错误时,请求在组内自动转移到下一个成员,agent 收到的仍然是一条完整的流式回复——这正是「配额撞墙不断线」的实现方式。
两个细节看得出设计者真的在高频使用:
- 会话粘性(session affinity):一轮对话被哪个账号回答,后续轮次尽量粘在同一个账号上——为了保住厂商侧的 prompt cache,否则每轮换账号等于每轮都重新 prefill,成本和延迟都翻倍;
- 组可以嵌套组:外层按场景分(写代码组 / 杂务组),内层按账号分,策略可以分层组合。
magpie quota 一条命令可以查所有订阅账号的剩余配额和窗口重置时间,这本身就是个刚需小工具。
七、Intent Routing:让小模型决定这轮该花多少钱
路由组之上还有一层 Intent Routing:每轮请求先过一个便宜的小模型判断意图,再决定走哪个组。典型规则:
- 「跑测试、修 lint、问正则」→ 便宜模型组;
- 「跨文件重构、架构推理」→ 旗舰模型组;
- 简单问答 → 本地 Ollama。
决策过程是可视化的——你能在 UI 里看到每轮请求被判定为什么意图、走了哪条规则、命中了哪个上游。这类「按意图分流」的思路在企业级 LLM 网关(Portkey、Kong AI Gateway)里已有,但把它做成个人工具里开箱即用、还带 trace 视图的,不多。
八、插件系统:跑在 Bun 上的网关中间件
magpie 的插件运行在 Bun(JS 运行时)上,magpie plugin add <npm 包> 即可安装,兼容 OpenCode 的 auth 插件生态。网关中间件暴露三个钩子:
onRequest:请求发出前改写或拦截(换模型名、注入 system prompt、挡敏感词);onEvent:观察流式过程中的每个事件;onResponse:拿到完整回复后处理。
自带的 New API 风格中间件已经覆盖了高频需求:param-override(强制参数)、model-map(模型名映射)、system-prompt(注入系统提示词)、word-guard(敏感词)、think-tags(思考标签处理)。新版还支持用 JS 插件自定义路由策略(注册新的 strategies)和 onUsage 用量事件监听。插件由 plugins.yml 管理、可开关,按需下载运行时,不污染主程序。
这个设计的聪明之处:核心用 Go 保证单二进制分发和性能,易变的策略逻辑外包给 JS 生态——用户自己写个中间件不需要编译,npm 装个包就能分享。
九、用量、成本与周边能力
几个在日常使用中实际会救命的能力:
- 用量与成本核算:token、cache 读写、按自定义价格算钱,每个账号分开统计;
- 会话列表与终端恢复:能看到历史会话,一键在终端里恢复某个会话上下文;
- 上下文占用分析:看清是哪些文件 / 工具结果吃掉了 context window;
- Web search MCP:给不能联网的模型挂
web_search/web_fetch工具,支持 Tavily、Brave、Exa、SearXNG;web_fetch带了 SSRF 防护(只允许公网地址 + 地址 pinning),不是裸的 fetch 代理; - Library:指令、MCP server、skills、subagents 写一次,magpie 按各 agent 自己的格式分别写入——和「配置改写器」是同一思路的延伸:写一次,翻译成 N 种方言;
- 共享与备份:局域网共享给其他设备(可带 key 和限额)、远程 magpie 接入、WebDAV/S3/GitHub 加密备份;
- OTLP 导出:用量数据可以接标准可观测性管线。
十、工程治理:LESSONS.md、破坏式测试与不收 PR
这个项目最让我在意的其实不是功能,而是它的开发过程本身。
仓库里有一份 LESSONS.md,维护者每晚复盘当天合并的代码。commit message 的详尽程度在开源项目里罕见:每个测试是怎么被手工构造输入先弄红、再写实现转绿的,都记录在案。CI 跑全平台 go vet / gofmt,GUI 有 Playwright 测试(chromium + webkit、5 种语言),甚至为上游依赖(modernc.org/sqlite 的纯 Go 实现)的 libc getenv 崩溃 bug 打过补丁。技术选型也克制:Go 单二进制 + Wails v3 做 GUI + SQLite 本地存储 + Bun 做插件沙箱,Docker 走 distroless 多架构镜像并带 provenance attestation。
产出模式同样有代表性:commit 里能看到 Co-authored-by: Claude Opus 5.5、glm-5.3-flash 等标记——一个人主导架构与验收,一支 AI 模型军团承担实现,再用极严格的验证流程兜底。3800+ commits、单月 200+ commits、一天之内十几个版本号(v0.1.1261 → v0.1276),这是传统单人维护不可能达到的速度。
但它有一个反直觉的治理选择:不收外部 PR。维护者只通过 Discord 收集反馈,所有代码自己(和 AI)写。理由也自洽——在这种高速演进 + 测试纪律要求下,外部 PR 的 review 成本高于自己重写。代价是社区的代码参与感弱,项目本质上是「源码可读、MIT 许可的开放产品」,而非社区共治项目。
隐私方面做得算透明:每日一次匿名心跳(随机 id、版本、agent/provider/model 计数),DO_NOT_TRACK=1 可关。
十一、适用、不适用与风险
适合用的人:
- 同时在用两个以上 CLI agent,配置切换已经成为日常摩擦;
- 有多个 provider key 或多份订阅,希望统一配额管理和自动故障转移;
- 想把 A 家订阅的模型用到 B 家 agent 里,并清楚其中的账号风险;
- 需要一个本地、可观测、可写中间件的 LLM 网关做二次开发。
不适合的人:
- 只用一个 agent、官方订阅就够用——README 自己也明说了这一点,magpie 对你是纯负担;
- 对「第三方程序接管订阅登录态」这件事在合规上无法接受的公司环境。
必须摆到台面上的风险:
- 订阅封号风险(最高):订阅桥接和 warm-up 本质上是在以非官方客户端方式使用付费订阅,违反多家服务条款的可能性很高。用于桥接的账号应默认「可能被封」,不要绑唯一主号;
- 凭证集中:所有 API key 和登录态集中到一个本地应用,它的安全性变成单点——好处是它开源、数据本地存 SQLite;代价是你需要信任它的更新通道;
- 版本速度与稳定性:版本号还在 0.1.x,日均多个发布,自动更新很勤快,但也意味着今天能用的行为明天可能调整;
- 「开放源码」≠「社区项目」:不收 PR、路线图封闭,决策完全依赖作者个人节奏,fork 自维护的成本不低。
十二、成熟度评估与结语
按工程证据而非 star 数判断:
- 能覆盖(已从代码与文档确认):四协议网关、60+ agent 的配置适配、五种路由策略、插件中间件、用量核算、全平台分发,子系统文档(
docs/subsystems/)与测试密度都说明这些是真实现的,不是 roadmap; - 部分覆盖(需自行验证):各家订阅桥接的稳定性高度依赖官方接口变化,属于持续猫鼠游戏;intent routing 的判定质量依赖规则配置;
- 不可覆盖(明确边界):它不解决合规问题,也不保证订阅账号安全;生产环境的多租户网关需求仍应走企业级产品。
magpie 真正的示范意义有两层。技术上,它证明了**「配置改写 + 协议网关 + 配额路由」三件套可以把碎片化的 agent 生态重新收敛成一台机器**——这和云时代统一接入网关的思路一脉相承,只是战场搬到了本地。方法上,yetone 展示了一种新的高产开源范式:一人握架构与验收权,AI 承担实现量,用破坏式测试、每日复盘和子系统文档把质量焊死。这种模式能否长期支撑一个有「封号猫鼠游戏」性质的项目,还有待观察;但它的工程纪律,已经比绝大多数 star 数更高的项目值得学习。
项目地址:github.com/yetone/magpie|官网:usemagpie.ai|安装:
curl -fsSL https://usemagpie.ai/install.sh | sh,或go install github.com/yetone/magpie@latest。本文基于 2026-10-17 的仓库公开文档与代码结构分析,未对全部功能做本机实测;订阅桥接类功能存在服务商条款风险,试用请使用非主力账号,后果自负。