写 LaTeX 的痛,大多数人不忍心细想:改一个字,等好几秒;看个效果,卡得心焦。 本地是漫长的全量编译,云端是 Overleaf 每次保存都要重新跑一遍整篇文档。你不是在"打字",你是在"排队"。
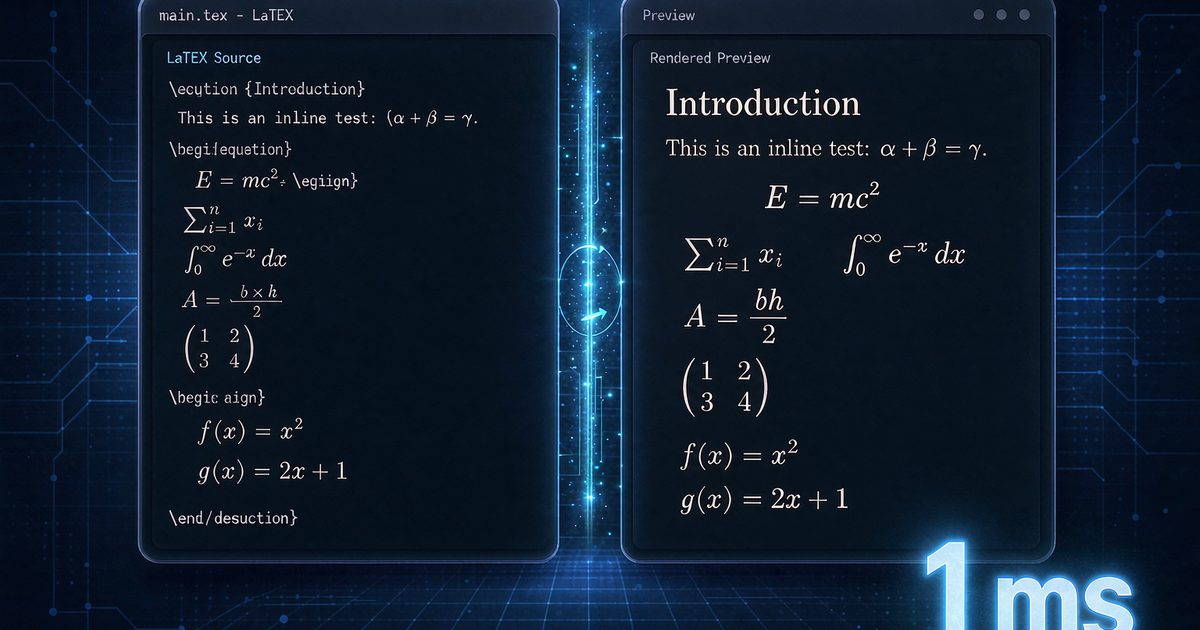
realtime-tex(下称 rtex)想解决的正是这件事。但它的思路不是把编译"变快",而是重新发明了编译的粒度——不再每次推倒重来地全量编译,而是让 LuaTeX 进程常驻内存,只重排你正在编辑的那一个段落,约 1 毫秒;至于分页、全局交叉引用、参考文献这类"真·全局"的东西,交给后台完整编译静默跟上。
这个项目由作者 HenryXiaoYang 打造,分两层:底层的 Rust 引擎 rtex(MIT,190 star / 20 fork,2026-10-07 创建),以及上层搭在它上面的 VS Code 插件 Realtime TeX Live Preview(TypeScript,MIT,48 star / 6 fork,2026-10-08 创建)。本文对两层一起拆解。
数据说明:本文信息主要来自两个 GitHub 仓库(默认分支均为
main,作者HenryXiaoYang)的README.md与文档:底层引擎realtime-tex的docs/benchmarks.md(2026-10-10 实测,rtex 0.0.2,4-vCPU 云服务器)及其docs/live-editing.md;插件realtime-tex-vsc-plugin的README.md(含全部设置项与命令清单)。数据快照时间为 2026-10-16。该项目创建仅一周余,处于快速迭代期,具体行为请以你所用版本与仓库最新文档为准。
目录
- 它是什么
- 真问题不在「编译快」,在「编译粒度」
- 架构核心:动静分离的双触发
- 性能基准:只跟段落走,不跟文档走
- 隔空叫板 Typst 与 Overleaf
- 精度:逐字形到 1/65536 pt 的确定性
- 字体:最大的性能杠杆
- 插件:零门槛上手与那些贴心细节
- 工程气质:精确才 live,不能证明就诚实降级
- 成熟度评估
- 结语
- 免责声明
一、它是什么
一句话:一个让 LaTeX 文案跟随你打字速度即时更新的实时排版引擎 + 配套 VS Code 预览插件。
它的工作方式不在网页对话框里。你打开一个 LaTeX 项目,打开 .tex 文件,点标题栏的预览图标(或按 Ctrl+Alt+V / Mac 上 Cmd+Alt+V),开始打字——预览面板里的那段文字就跟着每个按键刷新。而你手头的事,跟平常一样:改措辞、调公式、算引用编号。
底层之所以能做到"跟得上打字",是因为 rtex 不是每次给你重跑一遍整篇文档,而是让一个已经加载好导言区(preamble)的 LuaTeX 进程常驻着,你敲键盘时,它只把当前编辑的那一段重新排版,然后把新画好的那几行交给编辑器去画。
这个项目分化自两件事:一是作者自己写的 Rust 引擎(负责真正"快"的部分),二是上面包装的 VS Code 插件(负责"好用"的部分)。引擎卖的是能力,插件卖的是上手体验。 下面的章节,我会对两者都展开。
它自划的适用边界也很清晰:
- 合适:需要反复微调长文档、重排版成本极高、让人对编译等待不耐烦的 LaTeX 写作场景——论文、专著、报告;
- 不合适:只有打印需求、完全不在乎编辑体验的场景。以及——老实说——对 190 star 的新引擎,别指望它能一夜替代你打磨多年的工程链,这一点我会在成熟度评估里明说。
二、真问题不在「编译快」,在「编译粒度」
先给一个反直觉的立场:rtex 的核心创新,恰恰是它放弃了一个几乎所有工具都在追求的目标——“把全量编译变快”。
全量编译的缺陷是结构性的,跟硬件没关系:一篇 300 页的文档,你改的是第 57 页的第 2 行,但工具得把整篇从头排到尾——分页会变、引用编号要重算、目录要更新。这种"牵一发而动全身"的工作,无论机器多快,都是在一个和你的修改无关的尺度上白白消耗。
现有的替代方案也各有各的补不上的洞:
- Overleaf 之类的云端:每次重编译都等于把整篇文档交给服务器重跑一遍,所以你看到的不是你打字的"现状",而是"上一次编译的结果";
- Typst:它的确是增量式的,但它用的是自己的一套 markup,LaTeX 老用户的既有文档、既有宏包全部用不了——等于重写;
- LaTeX Workshop 这类本地编译器:自动监听保存并全量编译,本质仍是"重新造一遍完整文档"。
rtex 换了个问法:为什么我只改了一段,却要重排整篇? 于是它把"编译"这个动作拆成了两个粒度完全不同、互不干扰的部分。这就是下一节的"动静分离"。
三、架构核心:动静分离的双触发
rtex 用一个常驻 LuaTeX 进程,把一个按键触发的动作拆成两条并行的通道:
拆开看,每条通道各司其职:
- live 通道(局部、即时):只取你正在编辑的那一段,调用已加载好环境的 LuaTeX 重新排版那一块,约 1 ms 内返回该段的新行,供编辑器直接绘制。它服务的正是"我打一个字,它动一下"的即时反馈;
- background 通道(全局、兜底):一段文字的版面是独立的,但把它"装进"整篇文档就绕不开全局状态——这一行会推到哪里分页、
\ref/\cite的编号是多少、目录里那一行是什么、浮动体跑到哪、参考文献排出来是什么样。这些由后台一次完整编译静默更新,通常在你停顿一两秒之后才姗姗来迟——但你是无感的,因为它是"追着你的脚步",而不是"挡在你前面"。
这套"动静分离"是 rtex 对"1 ms"这个标号的真正支撑。它没有跟全量编译比速度,而是把"你关注的局部"从"整篇的全局"里剥离出来,让前者快,让后者不打扰你。
值得强调的一句:文档长度几乎不影响这条链路的耗时——因为 live 通道根本不看文档有多长,它只处理那一段。
四、性能基准:只跟段落走,不跟文档走
docs/benchmarks.md 里有份很扎实的实测(2026-10-10,rtex 0.0.2,一台 4-vCPU 云服务器,Intel Xeon 2.10 GHz,Linux + TeX Live 2026;笔记本通常更快)。每个数字是 300 次单字符编辑的中位数,间隔 2 ms,在预热会话里测得。
打字延迟(从 apply_edit 到编辑器拿到 ParagraphUpdate,包含显示列表解码,即除绘制外的一切):
| 段落 | 10 页文档 | 100 页文档 | 300 页文档 |
|---|---|---|---|
| 1 行 | 0.50 ms | 0.48 ms | 0.61 ms |
| 4 行 | 1.04 ms | 1.10 ms | 1.18 ms |
| 10–11 行 | — | 2.39 ms | 1.94 ms |
| 3 行含行内公式 | 0.89 ms | 0.90 ms | 1.24 ms |
第一行数字已经说明问题:300 页的文档,跟 10 页的一样快。 各种单元格之间 ±20% 的差异,一部分是共享 VM 上的噪声,一部分是每本书的段落文本本身不同——那 300 页的"行内公式"段落分数式更多,仅 TeX 阶段就 0.53 ms(对比 10 页的 0.31 ms)。
按单元类型看(同一本书只含每种单元):
| 单元 | 10 页 | 100 页 | TeX 阶段(100页) |
|---|---|---|---|
节标题 \section | 0.80 ms | 0.95 ms | 0.49 ms |
| 含 display 公式段落 | 1.38 ms | 1.65 ms | 0.79 ms |
| 含脚注段落 | 1.90 ms | 1.73 ms | 0.99 ms |
| 列表(itemize,3 项) | 1.68 ms | 1.53 ms | 0.96 ms |
| 图(图像 + 题注) | 1.74 ms | 1.68 ms | 1.07 ms |
| 表格(booktabs + 题注) | 1.52 ms | 1.70 ms | 0.98 ms |
这些环境的大部分时间花在 LaTeX 自己的机制上(\list、\halign、\@startsection、\includegraphics、计数器)。每种单元的 P95 都落在中位数 1.5 倍以内——只有 100 页书里那个脚注段落除外(4.3 ms)。
时间都去哪了(300 页书,单行段落,总 0.61 ms):
| 阶段 | 耗时 |
|---|---|
| TeX:恢复上下文 + 排版该 box | 0.16 ms |
| 遍历 box + 编码显示列表 | 0.07 ms |
| 其他:两次进程交接、线程唤醒、解码、会话 | 0.38 ms |
注意最后那行——固定成本占了 0.4 ms,全是进程和线程在按键间隙睡着后又被叫醒的花销。 这正是为什么"连续快速编辑"会比"零敲碎打"快 2-3 倍(连续击键时线程保持温热,单行可压到 0.23–0.27 ms,4 行 0.7–1.0 ms)。在笔记本上(上下文切换更快),这部分会更小。
后台通道(排版布局):一个 pass 是一次带 capture 包的 LuaLaTeX 运行。
| 文档 | 页数 | live 引擎就绪 | 首次布局 | 后续每次布局 | 纯净导出 |
|---|---|---|---|---|---|
| TFM 字体 | 10 | 0.6 s | 1.5 s(2 pass) | 0.5 s | 1.4 s |
| TFM 字体 | 100 | 0.7 s | 7.2 s(2 pass) | 3.1 s | 2.5 s |
| TFM 字体 | 300 | 0.6 s | 19.4 s(2 pass) | 9.4 s | 5.1 s |
| OpenType (node mode) | 100 | 1.2 s | 15.2 s(2 pass) | 6.9 s | 10.9 s |
长文档下,capture 包是主要开销——它要为每页写一份显示列表(JSON),约 120 KB/页,100 页书就是 14 MB。实测 100 页书两次 LuaLaTeX 运行:不带 capture 包 1.25 s,带上直接变 3.3 s。但注意:这些 pass 只在"你停止打字之后"才发生,live 更新全程不受影响。 作者自己也指认了最明显的下一步优化:改成二进制写页列表、且只写变动过的页面。
五、隔空叫板 Typst 与 Overleaf
同一个文本,三种工具在同一台机器上测(A4、11 pt、每段约 5 行,中间段落编辑 30 次):
| 页数 | rtex(每次编辑,P95) | Typst 0.15.1 watch | Typst 单页导出 | 全量 pdfLaTeX | 全量 LuaLaTeX |
|---|---|---|---|---|---|
| 10 | 1.6 ms (2.4) | 18 ms | 9 ms | 0.12 s | 0.52 s |
| 100 | 1.3 ms (1.7) | 146 ms | 47 ms | 0.25 s | 0.91 s |
| 300 | 1.3 ms (1.7) | 414 ms | 121 ms | 0.51 s | 1.69 s |
这个对比必须说明不完全是同一个量纲:
- rtex 的数字是段落本身;分页、页断、交叉引用由下一轮后台 pass 在几秒内追平(见上节);
- Typst 和全量 LaTeX 每次产出的是完整一致的文档,所以耗时会随文档长度增长;
- 全量 LuaLaTeX(0.52–1.69 s)就是 Overleaf 每次 recompile 的下限——它每次都要重跑整篇,何况在线服务还要额外加上排队、沙箱、下载和渲染的开销。
所以这组数字真正说明的是:你按下按键后,要等多久才看到"你打的那段文字被排版出来"。
- rtex:无论文档多长,一两个毫秒;
- Typst:几十到几百毫秒,且随文档变长而上升;
- 全量重编译:一秒甚至更多。
再看三者各自的选择(README 里那张表):
| rtex | Typst | Overleaf | |
|---|---|---|---|
| 语言 | 只支持 LuaLaTeX,直接沿用既有文档与宏包 | 自己的 markup,LaTeX 文档得重写 | LaTeX(pdfLaTeX/XeLaTeX/LuaLaTeX) |
| 输出 | 跟 LuaLaTeX 完全一致 | Typst 自己的排版结果 | 真实的 LaTeX 输出 |
| 打字时 | 段落立即精确,布局几秒后追上 | 每次编译全文档一致 | 每次 recompile 后全文档一致 |
| 协作 | 无,纯本地 | Web 应用,实时协作 | 实时协作、评论、历史、模板 |
| 环境 | 本机 TeX Live + Rust(插件会自动装) | 单一声明状态,或浏览器 | 浏览器 |
一句话总结各自的取舍:Typst 放弃"LaTeX 兼容",换来"天生增量 + 协作";Overleaf 放弃"即时反馈",换来"零配置 + 协作";rtex 放弃"协作",换来"LaTeX 兼容 + 即时反馈"。 三条路都通向"快",只是各放弃了不同的东西。
六、精度:逐字形到 1/65536 pt 的确定性
这是 rtex 最"较真"、也最容易被标题党忽略的一点。
很多"实时预览"插件为了快,会牺牲精度——预览给你看个大概,最终输出和真正编译结果不一样。rtex 反其道而为:预览和最终产物必须完全一致。
它用的是未修改的、来自 TeX Live 的原生 LuaTeX,所以:
结果就是 LuaLaTeX 产生的结果:同样的断行,同样的字形,同样精确到 1/65536 pt 的位置。导出的 PDF 与正常 LuaLaTeX 构建逐字节一致。
1/65536 pt 这个分母(TeX 的 sp 单位),意味着它不是"看起来像",而是数值上等价。
那么预览面板是怎么画的?README 里写得很清楚——编辑器直接绘制 rtex 输出的显示列表(display list),而不是先出一张 PDF 再显示,所以一次按键只需重绘一个段落,不需要 PDF 往返。它能画这些东西:
- 按字形索引(glyph index)绘制的 OpenType / TrueType 字体;
- 通过 TeX 的
pdftex.map找到的 Type1 字体(如 Computer Modern 数学字体和lmodern); - 颜色、规则线、PNG/JPEG/PDF 图像,以及
graphicx的缩放。
但也有一些页面没办法只用显示列表画出来——比如 TikZ 绘图或 \special。这类页面会从后台的 PDF 里呈现出来,并打上一个小 “from PDF” 标记;不过,你对这些页面上的编辑,仍然会以 live 的方式叠加显示在其上。
这就是"动静分离"在绘制层面的一次延续:能精确画的,实时精确画;不能精确画的,明确告诉你它退回用 PDF 了。 绝不装作"我都能实时渲染,且都一样精确"。
七、字体:最大的性能杠杆
README 里有个相当反直觉的结论:字体设置,比文档长短更能决定 live 更新的快慢。
同一本 300 页书,三种字体方案:
| 字体方案 | 1 行 | 4 行 | 11 行 | 行内公式 |
|---|---|---|---|---|
[T1]{fontenc} + lmodern(TFM) | 0.61 ms | 1.18 ms | 1.94 ms | 1.24 ms |
fontspec,TeX Gyre Pagella,Renderer=Basic | 0.61 ms | 1.27 ms | 2.29 ms | 1.05 ms |
| fontspec,TeX Gyre Pagella,默认(node mode) | 0.85 ms | 3.70 ms | 9.17 ms | 2.47 ms |
差一个"默认 node mode",11 行段落直接从 1.94 ms 暴涨到 9.17 ms——几乎 5 倍。 原因是:node mode 下 luaotfload 每次编译都在 Lua 里重新做 OpenType 整形(shaping);对那个 11 行段落,TeX 阶段就花了 8.0 ms(对比 TFM 的 0.9 ms)。
而 Renderer=Basic 用引擎自带的连字与字距表,跟 TFM 一样快。Renderer=HarfBuzz(HarfBuzz 模式)比 node mode 还慢。
所以如果你想要拉丁文本最快的更新,官方建议直白到一句口诀:用 Renderer=Basic 或 TFM 字体。 这条对中文/东亚文本的适用性仍需按你的文档实测——但"打字体验可以是一根杠杆"这个结论本身,值得每个 LaTeX 用户记住:
你的实时预览有多跟手,很大程度上取决于你用什么字体加载方式,而不是你写了多少页。
八、插件:零门槛上手与那些贴心细节
底层引擎再快,如果装起来劝退,也是白搭。Realtime TeX Live Preview 在这方面做得很细。
一键安装与引导。 首次使用,插件会自动检测缺什么:
- rtex 没装:点 Install rtex,它会下载你这平台最新 release 的预编译引擎(几 MB),并校验其 SHA-256。想自己构建?Build from Source 会克隆
realtime-tex的main用 Rust 的cargo编译(几分钟;Windows 上还需要 Git for Windows 和 rustup 要求的 Visual Studio C++ Build Tools)。realtimeTex.installFrom设置决定 Install rtex 走哪条路; - 没找到 LuaLaTeX:让你选 TeX Live 的
bin目录,或者让插件帮你装一个精简版 TeX Live 2026。
命令面板里的 Realtime TeX: Check Setup 会逐项检查并给出修复。插件还会自动维护它装的 rtex(下载版更新到最新 release,源码版拉取 main 重新编译),每天检查一次并弹 Update Now;Realtime TeX: Update rtex Engine 可随时手动更新并重启引擎。
主文件识别。 它会按顺序自动找主文件:% !TEX root = main.tex 注释 → 含 \documentclass 的文件 → \input 或 \include 当前文件的文件。有歧义就问你选,结果存入 realtimeTex.mainFile。
沉浸式写作的功能矩阵(这是插件层真正让体验"丝滑"的部分):
| 功能 | 说明 |
|---|---|
| 状态胶囊(Status pill) | 「Live · 0.8 ms」 表示该段以这个速度被重排;「Updating layout…」 表示正做全量编译补页码/引用/浮动体;「Up to date」 表示全部一致;「N errors」 打开问题面板 |
| 实时标记(live markers) | 行号旁的竖条:绿色实线 = 随打字实时更新;琥珀色虚线 = 等待全量编译(导言区、TikZ 等)。悬停能看到"为什么它退到全量编译了" |
| 光标跟随 | 预览自动滚动到你正在编辑的段落,Ctrl+Alt+J 随时跳转 |
| 反向跳转 | 在预览里双击(或 Ctrl/Cmd+单击)某个段落,直达源码 |
| 缩放 | Ctrl + 鼠标滚轮,Ctrl + = / − / 0 |
| 导出 PDF | Ctrl+Alt+E,写出到主文件旁的 main.pdf,结果与纯净 LuaLaTeX 构建完全一致 |
| 错误诊断 | LaTeX 错误与警告出现在 Problems 面板,源码里以波浪线标出 |
哪些内容会随按键即时更新? 正文、行内与 display 公式(align 等)、\ref/\eqref/\cite(用上一次全量编译的编号)、列表、定理、图与表格内容、标题、脚注标记、你自己的宏与环境、以及绝大多数宏包。
哪些会等下一次全量编译(通常 1-2 秒后)? 导言区改动、TikZ、移动后的浮动体、页面底部的脚注文字、新的分页。状态胶囊会提示此刻正处于哪种状态。
九、工程气质:精确才 live,不能证明就诚实降级
这一节我想单独讲讲它作为"工程"的态度——因为这可能是它最值得其他工具学习的地方。
rtex 设计里有一条近乎偏执的约束,README 反复强调:它绝不会推送一个它无法证明"精确等于完整 LuaLaTeX 输出"的 live 结果。
具体在引擎侧的体现是 realtimeTex.engine.eligibility 设置(默认 probe):有两种策略来决定"哪些部分可以 live 更新"——
probe(默认):把一次 live 结果与上一次完整编译反复比对,验证没问题才采用。这是"实证派";allowlist:只允许已知安全的命令参与 live,其余全部交给全量编译。这是"保守派"。
无论哪种,底层逻辑一致:当 rtex 无法证明某个 live 结果是精确的,它会直接告诉你为什么,然后让那个段落等到下一次后台 pass 再出现。 它宁可让你多等 1 秒,也绝不多给你一个"看似对、实则错"的瞬时结果。
配套的还有一次 updateCheck 之外的稳健性设计——fastBudgetMs(默认 50 ms:某部分实时重排如果连续 3 次超过这个预算,就改用全量编译兜底)和 pictureCache(默认 true:复用上一次全量编译里未改动的 TikZ 图片,实测能把一个 111 页 120 张图的文档的 pass 从 45 s 缩到 18 s)。
再看一眼调试侧。realtimeTex.debug.enabled(默认 false)开启后,只要 live 引擎挂起或崩溃,rtex 就会存下一整份调试包(源码、上下文、trace、TeX 日志),并在 requests.log 里记下每次 live 编译;Open Debug Folder 直接打开它们。
这套组合给的信号很一致:它把"可验证性"和"诚实降级"当成了第一性,把"快"当成了结果,而不是目标。 在一个人人都标榜"AI 极速渲染"的赛道里,愿意主动给"什么是不能 live 的"划一条边界,其实比报一个更大胆的毫秒数更难得。
十、成熟度评估
客观看看这个项目:
| 维度 | 现状 |
|---|---|
| 引擎 | rtex,Rust,MIT,190 star / 20 fork,2026-10-07 创建 |
| 插件 | realtime-tex-vsc-plugin,TypeScript,MIT,48 star / 6 fork,2026-10-08 创建 |
| 许可 | 两层均 MIT,对商用/二次开发极友好 |
| 性能数据 | 有独立 docs/benchmarks.md,基准可复现(rtex bench,且与 TUG 2026 论文基准联动),有精度(1/65536 pt)与字体三方案的实测 |
| 测试 | 插件带单元测试(node:test)、typecheck、以及驱动真实 VS Code 的 E2E 套件(需要构建好的 rtex + TeX Live);引擎有 rtex bench 内置的 CI 门槛检查 |
| 工程诚意 | 边界清晰(精确才 live)、分级降级(probe/allowlist、fastBudgetMs、pictureCache)、完整调试包、undo 式诚实——不像新人作品 |
| 成熟度 | 极早期:创建一周余,两层仓库体量均小,需观察后续迭代与维护 |
已经验证过的:动态分离架构成立;live 通道 300 页与 10 页同速;预览与最终产物逐字形一致(1/65536 pt);插件能零门槛自动装引擎与精简 TeX Live;错误/警告能进 Problems 面板。
仍待观察 / 值得注意的边界:
- 项目太年轻:创建一周余、star 少。它的"只影响文档复杂度,不影响文档长度"是优雅的,但到底能不能接住你那篇有几百个自定义宏 API、几十个宏包、复杂的
cls的工程文档,需要你自己拿真实工程试; - 只支持 LuaLaTeX:XeLaTeX / pdfLaTeX 的老工程无法直接受益;这是精度的前提,也是一个明确的适用范围;
- 依赖本机环境:需要 TeX Live(至少含 LuaLaTeX)与 Rust(若源码构建)。插件的"一键装精简 TeX Live"缓解了,但完整 TeX Live 仍是硬前提;
- 无协作:纯本地、单机。需要多人协同的场合,它和 Overleaf 不在同一战场;
- capture 包仍是重头:后台 pass 里 120 KB/页的 JSON 显示列表、14 MB 的 100 页书,作者已点名是下一步优化对象;文案规模极大时后台追平会更重;
- 中文/东亚字体需实测:README 给出的"最优"建议是针对拉丁(TFM / Renderer=Basic)。中文文档默认走
ctex/fontspec,那个"node mode 慢 5 倍"的坑很可能会踩到,建议你就自己的中英混排工程跑一次Realtime TeX: Check Setup+rtex probe,确认 lean 后再上。
适合谁用:已经用 LuaLaTeX 写长文、被"改一个字等几秒"折磨、但手里那套工程链(宏包、自定义环境、模板)不想重写的科研党与写作者;愿意为"即时反馈"把导言区、字体加载方式稍微调优的人;以及想研究"实时排版引擎怎么做粒度切分"的开发者——它的动静分离 + 逐字形确定性的组合,是很值得抄的思路。
不太适合:XeLaTeX / pdfLaTeX 老工程;需要多人实时协作的团队;改造意愿低、只想要"一键装完就能跑"的纯尝鲜用户(它确实能装,但上限取决于你的文档)。
十一、结语
把 rtex 拆开看完,我想说它最值得记住的,不是"1 ms"这个能上标题的数字,而是它用另一个角度重新定义了这个问题的答案:
- 它没有试图把全量编译变快,而是把"你改的局部"从"整篇的全局"里拆出来——编译的粒度,比编译的速度更本质;
- 它用"可证明的精确"换取"可接受的快",预览与最终产物逐字形一致(1/65536 pt),不给你一个"看起来对、实则错"的瞬时结果——诚实,在这里是一种性能指标;
- 它清清楚楚地告诉你哪里降级了(TikZ 退回 from PDF、probe 不通过就等后台 pass),而不是装作无所不能——边界,是工程成熟度的一部分;
- 它甚至点出了那个最大的杠杆:换一种字体加载方式,比买一台更强的电脑更能提升你的打字流畅度。
但我也得把丑话说在前面:这是一个创建才一周余的新引擎,48/190 star,MIT,很吸引人,但距离"拿你几十万字、几百个宏的工程文档去信任它"还有一段路。 你完全可以从一个小的 test book 试起——正如它 README 里自带的 gen-book 和 verify——先确认它能精确接管你的文档,再让它跟着你一起打长文。
在"AI 生成速度"被反复吹捧的当下,一个愿意谈"1/65536 pt 精度"、谈"我证明不了就不 live"、谈"你不是要更快,你是要跟上你打字"的项目,本身就值得被记住。
引用与延伸:《Real-Time LuaTeX: Recompiling Large Documents in 1 ms》(Clemens Lode,TUGboat 2026)是该设计的理论来源,其基准也随 rtex 一起分发、可复现。
免责声明
本文为个人学习性质的项目文档解读,不构成对该软件的推荐、担保或安全评估。rtex 与 Realtime TeX Live Preview 均为 MIT 许可的开源项目,处于快速迭代期(截至快照 2026-10-16,两层仓库均创建一周余);文中性能与精度数据来自项目自身的
docs/benchmarks.md(2026-10-10 实测,rtex 0.0.2,特定 VM),不完全代表你的实机表现,强烈建议以你所用版本 + 真实工程实测为准。特别提示:① 该项目仅支持 LuaLaTeX,XeLaTeX/pdfLaTeX 与依赖其的既有工程无法直接受益;② 使用全程依赖本机 TeX Live 与 Rust(源码构建时),插件可代装精简 TeX Live,但完整环境仍是硬前提;③ 中文/东亚字体的实时性能与 README 针对拉丁文本给出的最优建议可能有出入,请先对你自己中英混排的文档跑一次Check Setup与rtex probe再决定。