你有没有过这样的时刻:在一个 App 里发现一个做得很漂亮的功能,想在自己的项目里复刻它,但手里只有一个安装包。
没有源码,没有文档,混淆过的 JS 读不懂,二进制更是只能看到一堆汇编。这时候通常有两条路:一是买个 Hopper/Ghidra 会员坐进去一格格啃,二是去 GitHub 上找有没有人已经扒出来了——十有八九没有。
REA 想解决的就是这两条路之间的空档。它的定位写在 README 标题下面:Reverse Engineer Anything,一个 MCP 服务同时覆盖原生二进制、应用结构和运行时行为。
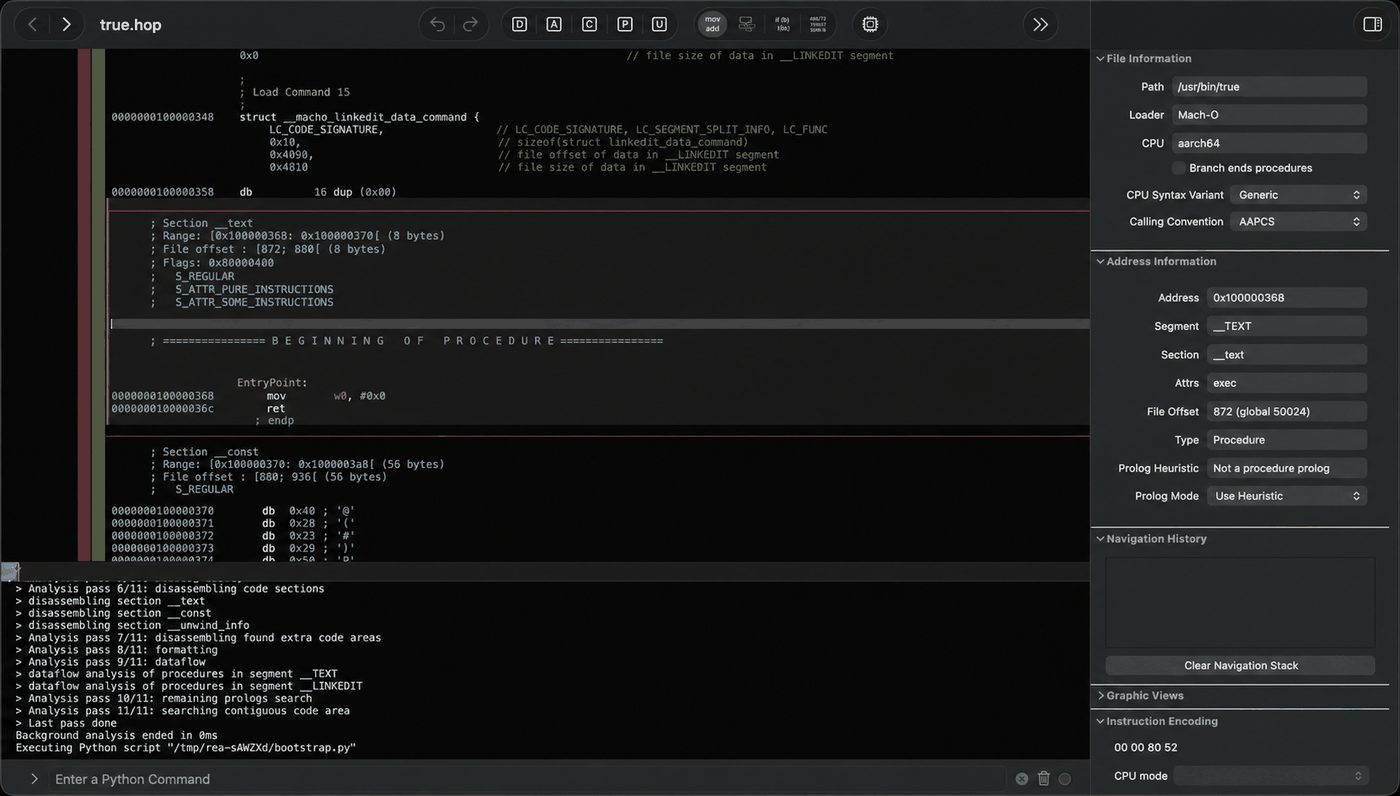
它的 slogan 更直接:See a feature you like. Understand how it works, down to the binary level.
六个月内,这个项目在 GitHub 上攒到 104,150 star、22,856 fork,仓库创建于 2026-04-14,MIT 协议,最新版本 v6.4.0 发布于 2026-10-11——也就是我采集数据的前一天。
下面把它拆开看:它到底能分析什么、架构怎么搭的、有哪些地方值得抄、有哪些地方要小心。
一、它解决的是一个很具体的痛点
先把场景说清楚。逆向工具的现状是割裂的:
- 想分析原生二进制,得学 Hopper 或 Ghidra 的交互逻辑,记快捷键,理解数据库概念
- 想看 Electron 应用,那又是另一套——解 ASAR、扒 preload、追 IPC
- 想看 APK,需要 JADX、Apktool、adb 一套组合
- 想看网站运行时,得自己搭 Playwright + CDP
每换一个目标就要换一套工具,每套工具都要重新学一遍。更麻烦的是,这些工具产出的结果格式各异:IDA 给伪代码,Ghidra 给 CFG,浏览器给 HAR 文件。你没法把它们拼成一个完整的「这个功能是怎么实现的」的答案。
REA 的做法是把这层割裂收进一个 MCP 服务后面。对 agent 来说,工具调用是统一的;具体的引擎差异被藏在 provider 层里。
这也解释了它为什么长成现在这样:539 个 provider 相关文件对 1,177 个 src/ 下的非测试 TypeScript 文件——大约三分之一的代码量花在做适配,而不是做核心逻辑。
二、上手只要一条命令
npx rea-agents setup
前提是 Node.js 22.x(≥22.19)、24.x(≥24.11)或 26+,外加 npm。包名叫 rea-agents,版本 6.4.0。
setup 做的事是:列出你要接入的 agent → 展示将要做的改动 → 你批准 → 写入 MCP server 配置和配套的工作流说明 → 备份原有配置 → 重启 agent。改动必须经过审批,这一点比很多同类工具省心。
它支持 17 个 agent 的自动配置,包括 Claude Code、Claude Desktop、Codex、Cursor、Gemini CLI、Windsurf、Copilot CLI、Qwen Code、VS Code、Grok Build、OpenCode、Devin 等,以及几个相对小众的(omp、pi、hermes)。任何支持本地 MCP server 的客户端也都能用手动注册的方式接上。
装完之后,交互方式就是跟 agent 说话:
Understand how search works in the Notes app, show me the evidence, and build a
similar feature for my project.
也可以完全脱离 agent,直接在终端用 CLI:
npm install --global rea-agents
rea --help
比如分析一个解包出来的 Electron 目录或 ASAR:
npx -y rea-agents@latest analyze-javascript-application /absolute/path/to/app --json
返回的是模块、imports、Electron 边界,以及这些结论各自的证据。更新用 rea update。
CLI 的命令集合是:analyze / search / function / decompile / instructions / xrefs / trace / providers / capabilities。最后两个用来问「这台机器上现在有哪些引擎可用、每个引擎支持什么」,比猜配置文件靠谱。
三、能分析什么:16 类目标
README 里的支持表格是这份项目文档写得像样的一处。每一行都写清了返回什么和需要什么前提,这点很关键——它不承诺「扔进来就能用」,而是老实列出依赖条件。
| 目标 | 返回什么 | 需要什么 |
|---|---|---|
| 原生二进制 | 伪代码、汇编、字符串、符号、调用与引用 | Hopper / Ghidra / IDA |
| 离线 ELF 布局 | 段、节、原始符号与重定位、缓解措施候选 | Linux x64 上自备 pwntools |
| WASM 制品 | 校验、节、精确的 import/export WAT 形式 | 自备 WABT 1.0.42 |
| EVM 字节码 | 分派选择器、字节偏移、推断参数与可变性 | Linux x64 上的本地载体 |
| Linux 崩溃转储 | 每个线程的寄存器与信号、可选映射候选 | pwntools,可选 GDB / pwndbg |
| JavaScript / Electron | 模块、imports、source map、路由、IPC 与原生插件关系 | 只需 Node.js 和 npm |
| 网站 | 页面结构、脚本、网络观测、指定截图 | Chrome 系浏览器 |
| 已保存的网络抓包 | 请求、响应、暴露的载荷、源码位置 | HAR;Linux 上抓 mitmproxy 需 mitmdump |
| .NET 程序集 | 元数据、CIL 指令、声明的原生依赖、构建对比 | 无需依赖(纯静态) |
| Android APK | Manifest 声明、类、反编译方法与引用 | 完整 JDK + headless JADX |
| Android 设备 | 设备、包、进程、日志、dump、截屏、文件传输 | 自备 adb |
| JEB 工程 | 引擎级工程单元、制品摘要、类型/方法伪代码 | 自行启动的 JEB 客户端 |
| Android 资源 | 解码后的 Manifest、字符串表、语言包、版本信息 | 自备 Apktool |
| 固件 | 区域划分、提取结果、原生分析交接 | Linux 上的 Binwalk / Unblob |
| 包与资源 | 文件清单、摘要、plist、Apple bundle 结构 | 无 |
| 进程行为 | 终端输出、交互、退出与文件系统观测、运行对比 | Linux / macOS + 原生 PTY |
一个容易被忽略的设计取向:静态 JS 分析和 .NET 分析不需要任何原生引擎。这意味着哪怕你机器上什么都没装,MCP 一注册就能干活——只是分析不了二进制而已。
运行时会跑起目标进程,用的是你的用户权限。项目在每个 runtime 指南里都写明了影响范围,这点比含糊其辞要好。
四、整个流程长什么样
这张图里有两处值得停下来看。
第一,AnalysisProviderRegistry 写着「确定性选择,不回退」。 意思是不做「Hopper 失败就悄悄换 Ghidra 再试」这种事。选哪个引擎是确定性的,失败了就把失败和局限报给你。这在科研意义上是对的——一个静默的 fallback 会让你以为结果来自 Hopper,实际上来自 Ghidra 的启发式反编译,而两者的伪代码质量差异极大。
第二,EvidenceLedger 和「未知项归属」是一等公民。 REA 不只是返回结论,而是把「没查出来的东西」也结构化地记录下来。这一点在第四节之后会展开。
五、六种工具形态,而不是一百个工具
docs/tool-design.md 里有一张表,是整个项目最值得抄的部分之一。
REA 没有采用「每个格式一个工具、一个动作一个工具」的堆叠策略,而是先定义六种任务形态:
| 形态 | 用途 | 返回什么 |
|---|---|---|
inspect | 关于某个目标、对象或资源的事实 | 字段、位置、以及各类切面是否可用 |
search / list | 候选发现 | 稳定排序 + 上下文,必要时分页 |
trace | 跨证据的关系 | 带类型的边、支撑事实、未解析的路径 |
compare | 显式配对的制品或观测 | 同一性、可比覆盖范围、有支撑的差异 |
workflow | 需要组合的、反复出现的结论 | 内联答案 + 贡献证据 + 部分完成的切面 |
observe / capture | 运行时行为 | 权限、启动/附加影响、生命周期、清理状态 |
文档明确写道:These are task shapes, not mandatory prefixes. 也就是说这是设计约束,不是命名规范。
我在 docs/mcp-contracts.md 里看到的实际工具名也印证了这一点——它们按动作和对象命名,而不是按形态加前缀:open_binary、analyze_function、compare_artifacts、trace_call_path、get_evidence_bundle、inspect_analysis_view、analyze_javascript_application、capture_browser_scenario、build_reconstruction_obligation_ledger……
文档里还有一条我觉得是整份 MCP 设计文档的核心主张:
Prefer primitives; compose workflows.
原子的工具只报告「关于某个已识别对象或关系的可复用事实」。一个格式专用的解码器算原子工具;但某个应用的业务解释不属于通用契约。只有当重复使用证明了「存在一个 REA 能完成、且不掩盖调用方选择和不确定性的多源结论」时,才把它提升成 workflow。
它还举了个反面例子:自研编排语言、重放引擎、独立的 prepare/execute 两段式计划——除非观察到原语满足不了的需求,否则不要做。以及一句很实在的话:
A plan without execution does not establish runtime behavior.(没有执行的计划不能确立运行时行为)
六、证据哲学:「没覆盖」不等于「不存在」
这是我认为 REA 最值钱的两个设计决定。
第一条:Missing coverage is unknown, not absence.
如果某个 provider 没有报告某条关系,REA 不会说「这条关系不存在」,而是说「这一项是未知的」。文档进一步规定:对 caller/callee 读取,relationship_coverage 只描述 provider 观察到的直接关系集合;标记为 complete 只意味着这个集合在没有已知读取上限的情况下被完整返回了,不代表运行时所有可能的边都被覆盖。
这个区分看起来是吹毛求疵,但在逆向工程里,误判「不存在」和误判「存在」的代价是同一个量级——都会把你引向错误的实现。
第二条:observed / derived / inferred 三态严格分离。
一条关系是直接从二进制里读出来的(observed),还是从多个观测推导出来的(derived),还是模型推断的(inferred)——这三种在返回结果里必须能被区分开。未解析的边和部分的 provider 事实要原样保留,而不是强行要求每个 provider 都填满同一套元数据。
配套的产物是 Evidence:每条证据带 evidence_id 和 analysis_profile,可以直接作为参数传给对比工具。这就是为什么 compare_artifacts 这类工具能做到「显式配对」——它配对的是有出处的证据对象,不是字符串。
再往上一层,还有一个我觉得很有意思的抽象:重构义务账本(reconstruction obligation ledger)。
build_reconstruction_obligation_ledger 把已认证的 Evidence 转换成一份确定性的重构声明清单。义务要算「闭合」,必须同时满足四个条件:
- 有且只有一个 owner
- 必需的 parser / schema / domain 类型都齐了
- 全部必需的 case fixture 都齐了
- 有权限可比(permission-comparable)的通过 verifier
这实际上是把「我大概明白了」变成了一份可被程序检查的清单。对要真正交付一个复刻版本的场景,这个约束比什么分析报告都管用。
七、架构:十层,依赖方向单向
docs/architecture.mermaid 是项目自带的架构图,我按原图的结构重画了一张精简版。原图有 11 个 subgraph、150+ 条连线,直接贴进来在博客里没法读:
几个能读出信息量的细节:
依赖方向是单向且有强制的。 AGENTS.md 里写得很清楚:领域语义与契约 → provider 适配器 → 共享应用工作流 → CLI/MCP 适配器。领域层是纯函数、无副作用。往上加一层都得问一句「这会不会反向依赖」。
进程层比想象的重。 src/process/ 负责自有进程组、私有根目录、超时控制、有界文件读取、诊断与清理。Windows 上还有一层 Node-API 原生实现(native/windows/src/),做 NTFS 准入、受保护 DACL 和原子的 Job Object 分配。
外部引擎通过 bridge 接。 bridge/hopper_bridge.py 跑在 Hopper 内部,把操作适配到 Hopper 的 Python API;bridge/ghidra/ReaGhidraBridge.java 打包成 HeadlessScript,提供 inventory、decompiler、references、CFG。
测试是真的多。 全量 file tree 有 2,870 个文件,其中 884 个是测试文件(Vitest),tests/fixtures/ 里放了假的 launcher、bridge 和 CDP 缝。测试覆盖率体现在架构里——那些 provider 都能被替身驱动。
项目用 Turborepo 管理,工具链是 Rolldown + oxlint/oxfmt + release-please,发布自动化做得挺完整。
八、把工程债摆在明面上
做大体量 MCP 服务,绕不开一个问题:工具 schema 和返回结果会把客户端撑爆。
REA 的处理方式值得单独说,因为它不是「我不返回那么多」,而是「我先量,再限,而且告诉你我限了」。
文档里一条硬规则:
An assumed agent budget is insufficient justification for a limit. (凭空假设的 agent 预算,不足以成为设置上限的理由)
对应的做法是:先测量资源,再选预算,在昂贵步骤之前就强制执行。文档要求把「价值替代、trace-frame 乘积、保留记录、序列化膨胀、临时文件增长」分别单独计账——而不是笼统地给一个数字。
几个已经落地的工程事实:
- 10 MiB 的 MCP 接收缓冲预算
REA_MCP_INPUT_SCHEMA_PROFILE=compact把输入 schema 压到 13,312 字节,专门为 Moonshot / kimi-cli 这类客户端准备(它们大约 13.7 KB 接受、~15 KB 拒绝)- 返回超限时触发
resource_constraint,配上details.reported_limits.evidence_reference,agent 随后可以用inspect_analysis_view分页续读 - 实际案例:一次 334 MB 的 Obsidian Evidence 被投影成约 10 KB 的 summary view,需要时再分页取
REA_MCP_MAX_RESPONSE_BYTES可控;REA_GHIDRA_STARTUP_TIMEOUT_MS/REA_HOPPER_STARTUP_TIMEOUT_MS应对大二进制的启动慢
「超限就明说,还能续读」这件事,比默默截断重要得多——它让 agent 的推理链不至于建立在残缺事实上。
九、安全边界写得相当克制
逆向工具天然带着一套「会不会乱来」的疑虑。REA 在 AGENTS.md 和 FAQ 里的边界写得很明确:
- 分析全在本地跑,不上传目标。(但 agent 会收到工具结果,而模型提供商有自己的数据策略——这句话也写出来了)
- Ghidra 用临时数据库,不改可执行字节,不控制 GUI
- IDA 只读,绝不保存或关闭已经附加的 GUI 数据库
- 安装器不碰 Homebrew、Node、npm、Java、Ghidra —— 不静默安装或升级别人的工具链
- setup 的改动先展示计划再等批准
- 敏感值需要脱敏,但不从命名去推断哪个值敏感
这几条单独看都不稀奇,加在一起是我愿意让 agent 在自己机器上跑它的原因。
十、三个案例,看它到底能走到哪一步
官方 showcase 页除了 README 里的三个,还列了几个社区案例。
DX-Ball:复现一个声音声像计算。 跟一个音效调用进到「位置转声像」的辅助函数,看指令,把不完整的伪代码翻译成 C。重构结果通过了 3,205 个原始 x86 用例,并且复现出全部 63 个编译后的函数字节——不是行为近似,是字节级一致。项目还开源了重构仓库(N0zoM1z0/dx-ball)。
Notion:追 Electron 剪贴板桥。 找到渲染进程的剪贴板 API,穿过 preload 和 IPC 进到主进程,检视富文本剪贴板格式。三个案例里这个最贴近日常——它演示的正是「看到一个功能,想知道它怎么做的」这个核心场景。
TH04:复原 DOS 版弹幕环。 查看 PC-98 原版游戏的 16 位指令,恢复固定角度与瞄准角度的计算,再把重构的 C++ 和历史编译器的输出做对比。
社区案例里还有 Aegis(分析 Android 认证器 APK)和 DownUnderCTF 的 flag checker。
DX-Ball 那个「复现全部 63 个编译字节」是我最看重的一个指标。逆向工具的输出历来止于「大概是这样」,而这里明确把验收标准定在可执行的等价性上——通过 3,205 个用例,还要字节一致。这正好呼应第六节那个重构义务账本:义务闭合的条件不是「我觉得懂了」,而是「有可跑的 verifier 通过了」。
十一、几个需要提前知道的限制
不是所有地方都适合它,坦白说清楚:
- 原生分析的门槛仍在。要 Hopper、Ghidra 或 IDA 之一。Hopper 可以由 setup 在你批准后安装,Ghidra 和 IDA 用你已有的(其中 Windows 上的 Ghidra 还标注为实验性支持)。
- 平台限制零散且真实。离线 ELF 要 Linux x64 + 自备 pwntools,EVM 要 Linux x64,进程捕获要 Linux/macOS 的原生 PTY,固件要 Linux 上的 Binwalk/Unblob。跨平台能力并不均匀。
- 它更偏「理解和取证」,不是自动化批量工具。文档明确反对为了「看起来像个平台」而造编排引擎、计划层。它给的是原语,agent 在上面自己组合。
- 版本迭代很凶。六个月内到 v6.4.0,几乎两天一个版本,新 release 常常带大量 bug 修复。文档里还专门有一节讲「最新 npm 版本之后才进主分支的特性」——用之前建议先看 CHANGELOG 对齐版本。
- 安装器会改你的 agent 配置。虽然有审批和备份,但涉及 17 种 agent 的配置格式,跨环境时值得先在干净目录试一次。
最后
REA 最值得借鉴的地方,其实不是它接了多少引擎,而是两条方法论。
一条是证据与结论分离:observed / derived / inferred 三态不混,「没覆盖」永远不等于「不存在」。这让 agent 在不完整信息下推理时,至少知道自己在哪儿是在猜。
另一条是验收标准机器可判:重构义务账本把「我懂了」翻译成「有唯一 owner、有必需类型、有全部 fixture、有通过的 verifier」。这一条把逆向从手感活变成了工程活。
从工程规模看,2,870 个文件、884 个测试、539 个 provider 适配文件、六个月 104k star,这个项目的执行密度不低。当然,六个月的高热度究竟是长期价值还是 novelty 效应,还需要更长的时间才能判断——但那些关于证据和验收的设计,跟热度无关。
如果你手头正好有一个「只有安装包」的复刻需求,REA 的快速上手路径值得先花十分钟试一次。
项目地址:github.com/morluto/rea 官网 / Guides / Showcase:rea.tools · 案例集 MCP 工具契约文档:docs/mcp-contracts.md 重构案例仓库:dx-ball · th04
本文数据采集于 2026 年 10 月 12 日,对应项目 v6.4.0 版本(发布于 10 月 11 日)。star / fork 数、文件统计与版本信息均为该时点快照;该项目迭代很快,实际使用前请以仓库 CHANGELOG 与
docs/installation.md的平台要求为准。逆向分析请仅用于你有权分析的目标,并遵守所在地区的法律与软件许可条款。