一张 12 GB 的家用显卡,能不能跑一个本该住在有数百 GB 显存的服务器上的大模型?Strata 给出的答案是:能,而且不是勉强跑起来,是跑得比人读得还快。
它不是去"缩小模型",也不是把权重量化到不可用——它跑的是 Qwen3.8-Flash-Next,一个 1250 亿参数的 MoE(混合专家)模型,由 24576 个小专家组成,每写一个词只需要其中 10 个。Strata 做的事情,是把这个模型的计算摊到整台电脑上:显卡管最重要的那部分,内存装下全部专家,CPU 在内存里就地算显卡没装的专家,SSD 只放一张大查找表。
它已经火了:截至本次快照,仓库 18465 star、1647 fork,从 2026-09-24 创建到 2026-10-08,两周多一点。MIT 许可,C++ + CUDA/HIP 实现,Windows 和 Linux 都支持。
这篇不写安装教程(README 里那套双击 START-HERE.bat 就够了),而是把它拆开看:为什么 MoE 模型天然适合"摊到整台电脑"、三层内存到底各放什么、那个"先猜再检查"是怎么做到不牺牲质量还快 1.6–1.8 倍的、为什么长文档能跑到每秒 1000+ token,以及它那套近乎苛刻的测量与工程纪律。
数据说明:本文信息来自项目 GitHub 仓库(
Niko1221/Strata)的README.zh-CN.md、docs/HOW_IT_WORKS.md、docs/DETAILS.md、docs/MODELS.md、docs/BATCHING.md、docs/MCP_SERVER.md、docs/DISJOINT_EXPERT_CACHE.md、docs/KV_PREFETCH.md与AGENTS.md,数据快照时间为 2026-10-09(仓库状态:主分支main,MIT 许可,18,465 star / 1,647 fork / 106 watch / 479 open issue,2422 个文件,主要语言 C++)。项目仍在快速迭代(引擎已迭代到 0.1.4x 区间),具体行为请以你所用版本与仓库最新文档为准。
目录
- 它是什么
- 要解决的只有一件事:显存
- 核心思路:把工作摊到整台电脑
- 三层内存分工:显卡、内存、SSD 各放什么
- MoE 的本质:24576 个专家的按需调度
- 先猜再检查:MTP 投机解码
- 长文本读取:8192 token 分块与 PCIe 专家流式
- 实测速度:NVIDIA 与 AMD
- 模型选型:4 个规格 × 4 个版本
- 一键安装,以及让 AI 帮你装
- API 兼容层:OpenAI / Anthropic / Responses
- 批处理:一次回答多个请求
- 工程气质:那些 opt-in 环境变量
- 成熟度评估
- 结语
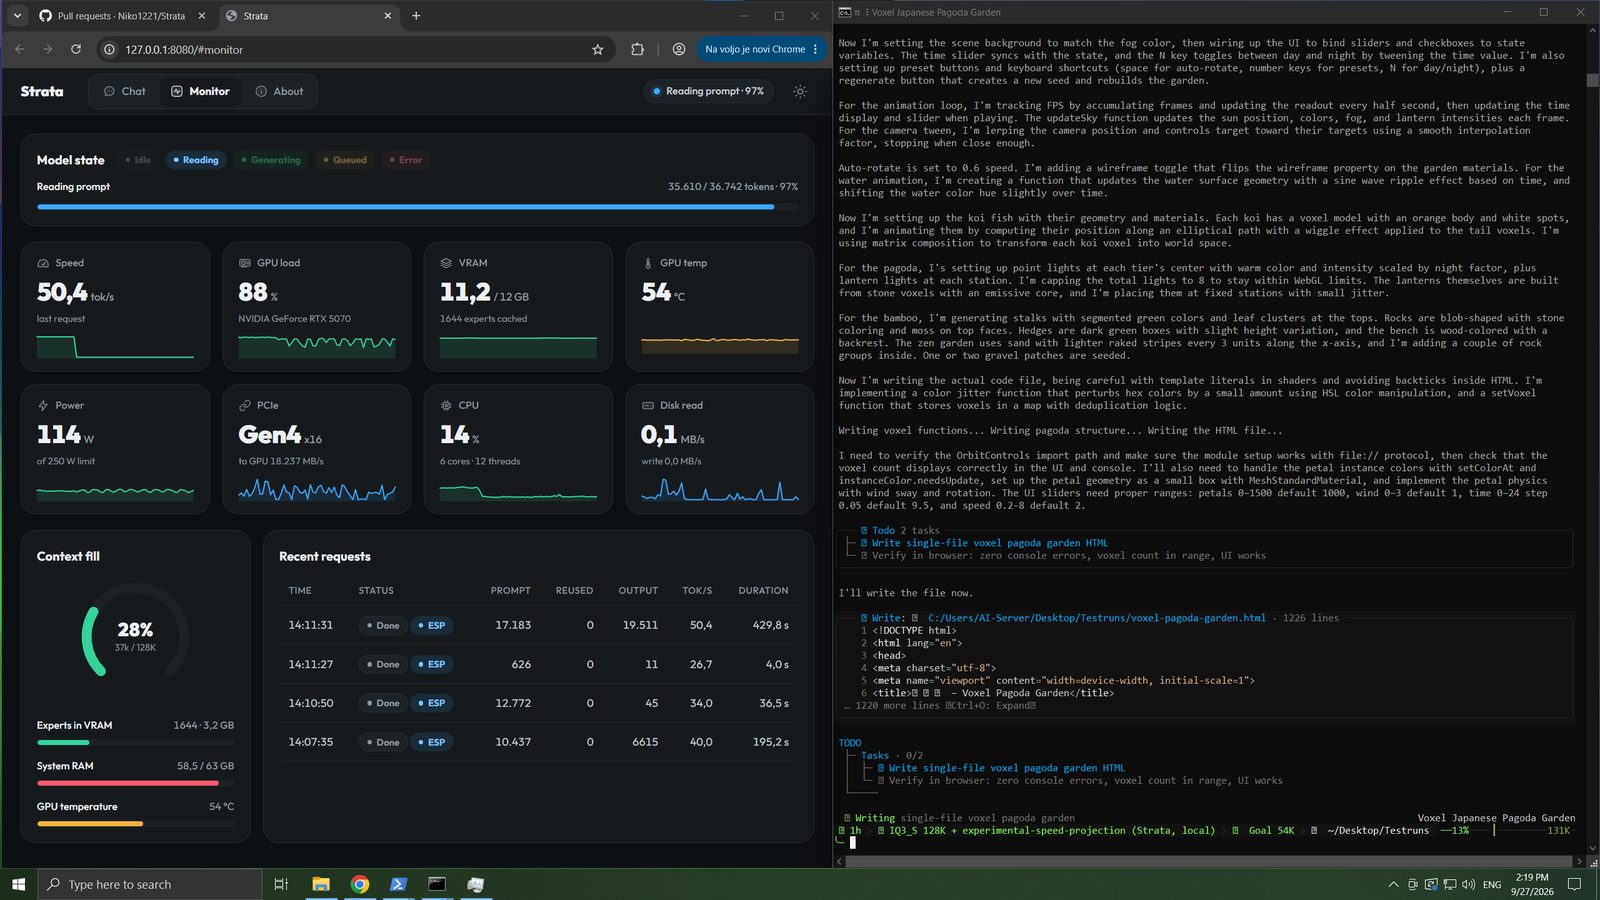
一、它是什么
一句话定义:Strata 是一个在本机运行 MoE 大模型的推理引擎 + 一键安装器,让 Qwen3.8-Flash-Next 在普通家用电脑上跑起来,并暴露成一个 OpenAI / Anthropic 兼容的本地 API。
它要你接受的前提很朴素——一张 12 GB 以上显存的 NVIDIA 或 AMD 显卡,32 GB 以上内存,约 80 GB 硬盘。除此之外,“安装程序会搞定”。
装好之后你得到的是:
- 浏览器界面:打开
http://127.0.0.1:8080,里面有 Chat(聊天)、实时 Monitor(监控模型和你的 GPU/CPU/内存)、About(设置和地址); - OpenAI 兼容 API:给你的应用或编程智能体加一个提供商,base URL 填
http://127.0.0.1:8080/v1,API key 和模型名随便填都行; - Anthropic 兼容 API:
/v1/messages,Claude Code 直接设ANTHROPIC_BASE_URL=http://127.0.0.1:8080; - Codex CLI 兼容:走
/v1/responses; - MCP 服务器:让你的 AI 编程助手(Claude Code、Cursor、Copilot、Codex 等)一句话安装、启动、停止、测速 Strata。
所有数据都留在你的电脑上。它不是云服务套壳,是一个真真正正在你本地算的引擎。
二、要解决的只有一件事:显存
理解 Strata,先理解它面对的只有一个约束:
Qwen3.8-Flash-Next 这种级别的模型,本来运行在拥有数百 GB 显存的服务器上。而你的显卡只有 12–24 GB。
这就是全部问题。它不是“如何让模型变聪明"的问题,也不是“如何让模型跑得快"的问题——而是**“如何让它装得下”**的问题。
而 Qwen3.8-Flash-Next 恰好有一个特性让这件事变得可能:它是一个 MoE 模型。MoE 的关键洞察是——模型里绝大多数权重,在写当前这一个词的时候根本用不到。
这就是 Strata 的全部思路,一句话能说完,但把它做对需要非常多的工程。
三、核心思路:把工作摊到整台电脑
项目的官方比喻是厨房:常用的东西放在台面上(显卡),其余的全部放储藏室(内存 + SSD),要用的时候再去取。
关键在最后一句:每个词只需要 10 个专家。也就是说,模型不需要把 24576 个专家都放在显卡上——它只需要把最常用的那几千个放上去,其余放在内存里,CPU 和显卡同时各自算自己负责的部分,谁也不用等谁。
这个思路对 NVIDIA(CUDA)和 AMD(HIP)完全一致——同一个引擎,分别编译一次。
四、三层内存分工:显卡、内存、SSD 各放什么
这是全项目技术含量最高的一段。Strata 把整个模型按"谁用得多、谁用得少"切成了三层:
| 存储层 | 放什么 | 具体内容 |
|---|---|---|
| GPU(VRAM) | 每个词都要用的 + 最常用的专家 | Attention 与 DeltaNet mixer、gated-residual 权重、router、共享专家、输出头、MTP 草稿层;KV cache(从 64K 上下文起只留最常读的那部分,其余从内存流过来);专家缓存——把剩下 VRAM 填满最常用的专家,而且在对话过程中自适应 |
| RAM | 全部 24576 个专家(pinned) | CPU 用 AVX-512 / AVX2 内核(i-quant 用 ggml 的)就地算显卡没装的专家,与显卡同时进行 |
| SSD | 一张 28.8 GB 的 n-gram 查找表 | 每个 token 只读其中几行,走操作系统缓存之外的无缓冲直读(--ple-io direct) |
这里有三个容易被忽略的细节:
① “多显存"比"快显卡"更重要。 项目原话:每多 1 GB 显存,能多放约 700 个专家;而每多一个在显卡上的专家,就是 CPU 少算一个。
② 专家缓存在线自适应。 显卡上那个专家缓存不是装好就固定了,它会根据你正在聊的内容边用边学哪些专家更常被调到。这是让它"越聊越顺"的关键。
③ 显存少、显卡大的反向场景也有解。 叫 low-RAM mode:当内存装不下全部专家时,setup 改成从模型文件映射,RAM 只留显卡放不下的那部分。比如一台 32 GB 内存 + 24 GB 显存的机器,就能这样跑 Q2_0、IQ2_XS 和 Coder。
顺带一句:
MULTI_GPU.md支持 2–3 张显卡分担同一个模型,甚至能做层切分(layer split)。单卡不够,可以加卡。
五、MoE 的本质:24576 个专家的按需调度
要真正理解 Strata 为什么能行,得回到 MoE 模型本身。它跟普通 Dense 模型(GPT-3、Llama 这类每个 token 都用全部权重)最大的区别是:
- Qwen3.8-Flash-Next 有 48 层,每层 512 个专家,共 24576 个;
- 写每一个词时,每层只激活其中的 10 个专家(top-10 路由)。
这个结构的直接推论就是:在任何一刻,绝大多数专家是闲置的。 那么把它们全部放在显卡上就是巨大的浪费。Strata 做的事情,就是把"闲置"的专家"放远一点”,用的时候再取。
但这里有个工程难题:“取"这个动作本身是要花时间的。 如果每次取专家都要等 PCIe 或 SSD,那模型会慢到没法用。Strata 的解法是:
- 显卡上放最常用的——绝大多数词命中,不用取;
- 内存里 CPU 就地算——没命中显卡的,CPU 在内存里算,和显卡同时算,谁也不用等谁;
- SSD 只放那张查找表——每个 token 只读几行,走直读,基本不成为瓶颈。
六、先猜再检查:MTP 投机解码
这是 Strata 另一个让速度翻倍的核心技术。它的名字叫 MTP(Multi-Token Prediction)投机解码,思路是:
一个小助手先猜接下来几个词,大模型一次性全部检查,保留正确的那些。
几个关键事实:
- 技术细节:模型自己的 MTP 层草拟最多 3 个 token;一次过全部 48 层检查它们,平均每个验证窗口前进 2.4–3.2 个 token;
- 质量完全一样——因为小助手只负责"猜”,每个词最终仍由大模型自己决定。这就是它和"蒸馏成小模型"的本质区别;
- 效果:1.6–1.8 倍加速;
- 还有一种叫 prompt lookup 的补充:当回答在重复上下文时(比如改代码、引用原文),它从之前的副本里草拟最多 5 个 token。但这个只在"实测收益 > 成本"时才启用——代码编辑场景快 6–11%,其他文本不变。
这种"先猜再检查"的设计,本质是把串行的单步生成变成并行的多步验证,是用算力换延迟,而不是用质量换速度。
七、长文本读取:8192 token 分块与 PCIe 专家流式
聊天快,读长文档也要快。Strata 的做法是:长文本分大块读入,每块最多 8192 个 token(--prefill auto,可以 opt-in 到 32768)。
关键细节:下一层需要的专家,在当前层 attention 运行的同时,通过 PCIe 流式上传到显卡。 这就是"预取”——计算和传输重叠,不让 PCIe 成为瓶颈。
效果:读长文档或代码库的速度超过每秒 1000 token。而且第一条消息之后,Strata 会保留对话,只读新增的内容,所以后续追问几秒内就开始回答。
项目还特别说明:读入第一条消息时,大约每 30000 个 token 需要 1 分钟(那是一次性成本,之后的消息很快)。
八、实测速度:NVIDIA 与 AMD
光说快不算数,Strata 项目最值得学习的一点是它把实测数据公开得非常彻底。以下是两台普通游戏电脑的官方测量(一个 token 约等于 ¾ 个英文单词):
NVIDIA:RTX 5070(12 GB)+ Ryzen 5 7600 + 64 GB 内存
| 规格 | 写回答(短对话) | 读提示(32K token) |
|---|---|---|
| Q2_0 | 94 tokens/s | 2,650 tokens/s |
| IQ2_XS | 79 tokens/s | 2,090 tokens/s |
| IQ3_XXS | 62 tokens/s | 1,750 tokens/s |
| IQ3_S | 53 tokens/s | 1,620 tokens/s |
| Coder | 55 tokens/s | 2,180 tokens/s |
AMD:RX 9070 XT(16 GB)+ Ryzen 9 3900X + 47 GB 内存
| 规格 | 写回答(短对话) | 读提示(32K token) |
|---|---|---|
| Q2_0 | 60 tokens/s | 1,160 tokens/s |
| IQ2_XS | 52 tokens/s | 1,110 tokens/s |
| Coder | 44 tokens/s | 1,420 tokens/s |
怎么读这张表?60 tokens/s 已经比你的阅读速度快了。也就是说,用 Q2_0 在 RTX 5070 上聊天,回复出现的速度已经超过人眼能读完的速度。
还有几个推论值得记:
- 显存越大越快:因为更多模型能放进显卡。项目估计 RTX 3090(24 GB)写回答能达到 约 100–140 tokens/s;
- 长上下文会慢一些:128K 上下文时,Q2_0 从 94 降到 76 tokens/s,IQ2_XS 从 79 降到 63;
- 4K 提示读得很快:约 910–1,580 tokens/s;32K 提示在 Q2_0 上约 15 秒读完;
- 每台电脑都不一样:
START-HERE.bat --calibrate会在你自己的机器上测几个引擎设置并保留最快的(约 15–30 分钟,慢卡更久)。项目实测,校准让 Coder 快了 7%。
社区也有专门的 benchmark 模板(
docs/COMMUNITY_BENCHMARKS.md),项目鼓励你测完自己的机器后用 PR 分享。
九、模型选型:4 个规格 × 4 个版本
Strata 跑一个模型,但有不同规格(同一个模型压缩得更多或更少)和不同版本(原版、编程版、微调版)。安装程序会按你的内存推荐一个,这里把选择逻辑讲清楚。
按内存选规格
| 你的内存 | 选 | 原因 |
|---|---|---|
| 32 GB | Coder | 装得下,专为代码打造(若显卡 24 GB,Q2_0 和 IQ2_XS 也能跑) |
| 48 GB | IQ2_XS(或 Q2_0,最快) | 更大的规格装不下 |
| 64 GB | IQ2_XS(推荐),或 IQ3_XXS / IQ3_S | 所有规格都装得下;IQ3_S 最好也最慢 |
| 96 GB 或以上 | IQ3_S,或 Unsloth 的 UD-IQ4_XS | 开着其他程序也能放下最大的规格 |
四个规格的 RAM+VRAM 需求和速度对比:
| 规格 | RAM+VRAM 需求 | 速度 | 质量 |
|---|---|---|---|
| Q2_0 | 37.6 GB | 最快 | 好 |
| IQ2_XS | 39.2 GB | 快 | 更好(推荐) |
| IQ3_XXS | 47.0 GB | 较慢 | 很棒 |
| IQ3_S | 54.8 GB | 最慢 | 最佳:在公开测试上与完整模型一致(仅原版模型) |
规格越小越快,越大越聪明一些。三个较小规格的下载是 66–76 GB;首次启动还会拉取 MTP 草稿层(约 6 GB,开图像再加 1 GB)。
四个版本
① Qwen3.8-Flash-Next(原版)——四个规格都有,支持图像输入,可选实验性 speed projection。
② Coder——ISTA-DASLab 的编程版。它只保留每层 512 个专家中的 256 个,按代码(含 agentic 和图像)数据挑选,丢掉另一半。达到完整模型 SWE-bench Verified 分数的 91%(LiveCodeBench 99%),由作者测得。 只有一个规格(IQ1_M),分片 1 是 29.6 GB,所以 32 GB 内存就能跑,64 GB 上能跑 262K 上下文,读长提示最快。
⚠️ 代价:去掉一半专家后,代码以外的能力变弱,包括中文和其他中日韩文本。项目明确提到 issue #438:中文回答出现错误或循环,而英文正常。一般用途,或内存允许时,请选保留全部专家的规格(Q2_0、IQ2_XS 或 IQ3_S)。
③ Swift 1.5——UkisAI 的微调版,回答前思考的时间短得多,你能更早拿到答案,质量基本不变。每个 token 速度相同,RAM 需求与同规格原版接近(没有 IQ3_S)。
④ Unsloth UD-IQ4_XS——Unsloth 的约 4-bit 版本,质量介于 IQ3_S 和 UD-Q4_K_XL 之间。下载 94 GB,专家 59.5 GB。内存少于约 80 GB 时,回答时要从 SSD 读其中一部分(NVMe SSD 有帮助)。
另有实验性的 UD-Q4_K_XL(最接近完整模型,但下载 111 GB、专家 77 GB 装不进内存,64 GB 电脑上每秒只有 7–8.5 token),以及需手动设置的 OrcaRouter Uncensored IQ3_XXS。
装不下怎么选?—— low-RAM mode
一台大显卡 + 小内存的机器怎么办?START-HERE.bat --setup --low-ram on|off 可以覆盖这个选择。比如:
- 32 GB 内存 + 24 GB 显存 → 能跑 Q2_0、IQ2_XS、Coder;
- 32 GB 内存 + 12–16 GB 显存 → 只能跑 Coder(显卡太小,很多专家要从 SSD 来,会慢很多,setup 会明确告诉你)。
十、一键安装,以及让 AI 帮你装
Strata 的安装设计得很"反技术”。Windows 双击 START-HERE.bat,Linux 运行 ./setup.sh,NVIDIA 和 AMD 步骤完全一样。安装程序会识别你的显卡、装好对应引擎,然后问你几个问题(哪个模型、哪个规格、上下文多大、是否识别图片)——每次直接按回车就是推荐选项。
之后它会下载模型(约 70 GB)并启动。下载中断了?再运行一次即可,它会从中断的地方继续。
让 AI 帮你装
这才是最妙的部分。如果你在用 AI 编程助手(Claude Code、Cursor、Codex、Copilot 等),把下面这段粘贴给它:
Set up Strata on this PC for me: https://github.com/Niko1221/Strata - follow docs/AI_SETUP.md in that repository.
它会检查你的显卡、内存和硬盘,选出合适的模型,安装并启动,再告诉你怎么连接你的应用。
MCP 服务器:AI 助手直接管理 Strata
更进一步,Strata 提供了一个 MCP 服务器(tools/strata_mcp.py)——一个只用标准库的 Python 文件,所以它在 setup 创建 .venv 之前就能用。你把它加进 AI 助手一次,就能用大白话指挥它:
- “Install Strata for this PC.”
- “Start Strata.” / “Stop Strata.”
- “Is Strata running? How much VRAM does it use?”
- “Which Strata model fits my PC?”
- “Strata didn’t start - what does the log say?”
- “How fast is Strata on this PC?"(一次简短测速)
- “How do I connect Open WebUI / the OpenAI SDK / Claude Code to Strata?”
它暴露的工具:
| 工具 | 做什么 |
|---|---|
strata_status | 是否有模型在跑(模型、引擎版本、上下文、忙/闲、VRAM 与 RAM 占用);已装了什么;这台电脑的硬件(OS、CPU、RAM、GPU、page file、可用磁盘);setup 推荐什么 |
strata_models | setup 提供的每个 family 和 size,含下载体积、所需 RAM、是否装得下、是否已安装、推荐上下文长度 |
strata_install | 无交互后台运行 setup;无 confirm: true 时只返回计划;再次调用显示进度;cancel: true 取消 |
strata_start | 后台启动已装模型并等待它响应;50 秒未就绪返回 “loading” |
strata_stop | 通过服务器自身 API 卸载模型,然后结束它启动的服务 |
strata_logs | 服务器日志、引擎日志或 setup 日志的最后几行 |
strata_benchmark | 发一个固定短请求(greedy、关闭 thinking),报告输出和提示的 tokens/s |
strata_connect_info | OpenAI 和 Anthropic 的 base URL、模型 id、是否需要 key,以及 Claude Code、Codex、OpenAI SDK、curl、Cursor、Continue、Open WebUI 的连接设置 |
它支持 Claude Code、Claude Desktop、Cursor、VS Code(Copilot agent mode)、Codex CLI 以及任何其他 MCP 客户端,传输用 stdio,说的 MCP 版本是 2025-06-18(也兼容 2025-03-26 和 2024-11-05)。
十一、API 兼容层:OpenAI / Anthropic / Responses
Strata 之所以能"无缝替换云服务”,是因为它同时兼容三套主流 API:
| 你想连的东西 | base URL / 设置 |
|---|---|
| OpenAI SDK / 任何 OpenAI 兼容客户端 | http://127.0.0.1:8080/v1 |
| Claude Code | ANTHROPIC_BASE_URL=http://127.0.0.1:8080(走 /v1/messages) |
| Codex CLI 及其他用 Responses API 的应用 | /v1/responses |
几个使用细节:
- API key 和模型名随便填都行——它本机跑,不需要验证;
- 思考:在聊天菜单或应用的 “reasoning effort” 里选 off、low、medium、high。off 最快,high 最适合难题;
- 图片:安装时对 “Images?” 选是,然后在聊天里点 Picture,或在应用里附上图片。AMD 显卡在 Linux 上通过处理器识别图片,Windows 上暂时还不行;
- 从手机或另一台电脑访问:
START-HERE.bat --setup --host 0.0.0.0 --api-key <secret>——一定要设 key; - 默认情况下 Strata 一次只回答一个请求,其他排队。想同时回答多个,见下一节。
十二、批处理:一次回答多个请求
默认单请求队列。用 "parallel": N(引擎参数 --batch N,也叫 --slots N),引擎会同时保持最多 N 个对话并一起解码:
关键收益:每个验证窗口携带每个对话的一个 token,所以多个会话共享的稠密权重、共享专家、输出头只需要读一次。配合跨多张显卡的层切分和 --batch-groups,各卡还能同时处理不同会话。
但它是有代价的:每个槽位的 session 都要占 VRAM(32K 上下文 + 8-bit KV 是 0.56 GiB/槽)。所以 setup 只在专家大多能装进 VRAM 时推荐开启并行。在专家主要在 CPU 上跑的卡上,并行只改善延迟(没人等一整段回答),单请求反而更慢 11–24%(专家缓存变小了)。
一个很有工程味道的设计——协作式抢占:当一个更短的请求在等时,服务端发 BYIELD,长请求在下一个块边界停下、已读的部分复制进槽位、短请求插入,长请求再从槽位继续。每请求最多两次。
另一个容易被低估的点:每个槽位就是一个对话缓存。 已完成回答的槽位保留它持有的内容(提示、回答、以及提示最后一次轮次边界处的 checkpoint)。同一对话的下一轮会回到那个槽位,引擎直接把状态复制回去(短对话 50–60 ms)而不是重读历史——即使用户把回答里的 thinking 从历史里丢掉了(checkpoint 匹配到新轮次)。
十三、工程气质:那些 opt-in 环境变量
Strata 最打动人的,可能不是它能跑多大模型,而是它对**“哪些东西默认关掉”**的克制。这些 opt-in 环境变量,每一个背后都是一次真实的取舍:
| 开关 | 干什么 | 实测收益 / 代价 |
|---|---|---|
STRATA_DISJOINT_ADAPT=1 | 避免助手卡和主卡重复存放同一专家 | 观测到 1900–2000 个重复槽位;两台改装的 RTX 3080 20 GB,生成提速 15.5%、请求时间降 12.2% |
STRATA_KV_PREFETCH=1 | 长上下文 KV 部分在内存时,让下一层上传与当前层计算重叠 | 32K:预填充 -5.3%;64K:-4.1%;8K 无改善,解码无提速 |
STRATA_RING_BYTES | 按字节给打包的流式环形缓冲区定尺寸 | 32K 提示下 IQ3_XXS +18.5%(1500 槽缓存),Coder +3%,IQ3_S 不变;4K 提示不变 |
STRATA_BATCH_MTP=1 | 批处理时每槽每窗口验证一个 MTP 提案 | RTX PRO 5000 实测 +31%~39% 总吞吐(2–4 客户端) |
STRATA_STAGE_TRIM=1 / --trim-stage-weights | 层切分时每卡只加载自己那层的稠密权重 | 省下的 VRAM 给专家缓存 |
STRATA_BATCH_DECODE_SHARE=0.5 | 预填充每个块之后解码的时间比例 | 默认 0.5:长提示拖慢其他请求但不完全停住它们 |
--ple-io direct / --ple-io ram | SSD 查找表走无缓冲直读,还是整表进内存 | 默认 direct(为 SSD 设计);机械盘用 ram(issue #605) |
STRATA_PREFILL_CPU_SHARE | 单 NVIDIA GPU 上 CPU 分担预填充 | 默认开 |
STRATA_PARALLEL_SOLO=0 | 关闭"槽位独占时回到 solo 路径" | 默认每请求最多两次回到 solo |
这里值得单独讲讲 SSD 上那张查找表。 它是 28.8 GB 的 PLE(Prompt Lookup Engine)n-gram 表,默认 IQ4_NL 格式。引擎按 GGUF 里存的格式读它:IQ4_NL(默认)、Q4_0、Q5_0、Q5_1、Q8_0、FP8(E4M3 带 scale)或 BF16。
项目对压缩格式的质量损失做了非常严谨的测量——在 4000 个随机行上对比 checkpoint 自己的 BF16 表:
| 格式 | 表大小 | 平均每行误差 |
|---|---|---|
| Q8_0 | 54 GB | 0.53% |
| FP8 | — | 2.64% |
| Q5_1 | — | 3.78% |
| Q5_0 | — | 4.25% |
| IQ4_NL | 28.8 GB | 7.60% |
| Q4_1 | — | 7.80% |
| Q4_0 | — | 8.55% |
再在 Q2_0 模型上、700 个 teacher-forced token 里对比 KL 散度:Q5_0 0.0117 / Q5_1 0.0121 / Q8_0 0.0125 / FP8 0.0128 / Q4_0 0.0140 / IQ4_NL 0.0146,perplexity 都在 BF16 的 1% 以内。
结论很有意思:改动这张表对 2-bit 模型的移动大约都是 0.012,所以这些格式很难区分。 于是 setup 不提供换表的选项——它只改变喂给引擎的是哪个 GGUF。这种"知道什么时候不值得折腾"的判断,本身就是工程成熟度的体现。
十四、成熟度评估
拉回现实,客观看一下这个项目:
| 维度 | 现状 |
|---|---|
| 活跃度 | 18,465 star / 1,647 fork / 106 watch / 479 个开放 issue;2026-09-24 创建,2026-10-08 仍有提交 |
| 仓库规模 | 2422 个文件,主要语言 C++,约 22 MB(不含模型),有 src/、include/、bench/、tools/、serve/、tests/、sycl/ 等完整工程结构 |
| 引擎迭代 | 已迭代到 0.1.4x 区间,文档里大量引用具体版本号(如 0.1.39、0.1.41)和 issue/PR 编号 |
| 测试纪律 | src/kernels/ 里有大量 *_parity.cpp(对偶校验测试)和 *_test.cpp;bench/results/ 按日期记录了每一次基准 |
| 文档 | docs/ 下有 46 个文件,从 HOW_IT_WORKS、DETAILS、MODELS 到 MULTI_GPU、MCP_SERVER、BATCHING,还有正式论文 docs/paper/Strata-Paper.pdf |
| 许可 | MIT(Strata 本体);模型文件有自己的许可;third_party/ggml MIT;网页字体 SIL OFL 1.1 |
已经验证过的:在两台不同的游戏电脑(NVIDIA 与 AMD)上都有完整实测;bench/results/ 记录了从 2026-09-24 到 2026-10-01 的多轮基准(RTX 3090 + EPYC Milan、社区 RTX 5090、2× RTX PRO 4500、SYCL 等)。
仍待完善/值得注意的边界:
- Coder 的中文较弱(issue #438:中文回答出错或循环,英文正常)——项目自己写在文档里,没藏着;
- AMD 在 Windows 上还不能识别图像(Linux 上走 CPU);
- 479 个开放 issue 说明项目还在快速迭代,也说明边界不少;
- 大量性能优化仍是 opt-in 的(默认关),说明作者对"默认行为稳定"的执念很强。
适合谁用:有一张 12 GB 以上显存显卡、想把大模型留在本机、在意数据不出门、愿意接受命令行和安装脚本的技术型用户;尤其是已经在用 Claude Code / Cursor / Codex 这类 AI 编程助手、想给它们配一个本地模型的人。
不太适合:没有独立显卡(只有核显)、显存低于 12 GB、或内存少于 32 GB 的机器;希望开箱即用、不想碰任何脚本的普通用户。
十五、结语
Strata 最打动我的地方,是它把一件"看起来不可能"的事情做成了,而且把每一步为什么这么做都讲清楚了:
- 该利用的利用——MoE 模型"每词只调 10 个专家"的特性,是它敢把专家拆到三层内存的根基;
- 该重叠的重叠——MTP 投机解码让"猜+验证"并行,PCIe 专家流式让"上传+计算"并行,KV 预取让"下一层上传+当前层计算"并行。它几乎在每一个可能卡住的地方都放了重叠;
- 该保守的保守——所有性能优化默认关,需要你显式打开;setup 只在你内存允许时才推荐并行;
--calibrate让你在自己机器上实测而不是盲信文档数字; - 该测量的测量——从 2-bit 模型的 KL 散度到 n-gram 表的每行误差,从 NVIDIA 到 AMD,从 4K 到 262K 上下文,每一个数字都标了测速环境和版本;
- 该承认的承认——中文在 Coder 上不行就写 #438,AMD Windows 暂不支持图像就直接说明,装不下就诚实告诉你会慢多少。
一个能把"12 GB 显卡跑 1250 亿参数模型"这件事,拆成三层内存分工 + 两处并行 + 一套严谨测量的项目,比一个声称"全面支持、无所不能"的项目更值得信任。这种知道自己每一步在哪、为什么这么选的克制,是它最像样的工程特质。
免责声明:本文为个人学习性质的项目文档解读,不构成对该软件的推荐、担保或安全评估。项目仍在快速迭代,文中数据为 2026-10-09 快照,具体行为请以你所用版本与仓库最新文档为准。涉及大模型部署、显存占用与系统资源消耗的操作,请自行评估风险,注意模型文件体积(66–111 GB)与首次启动的资源占用。